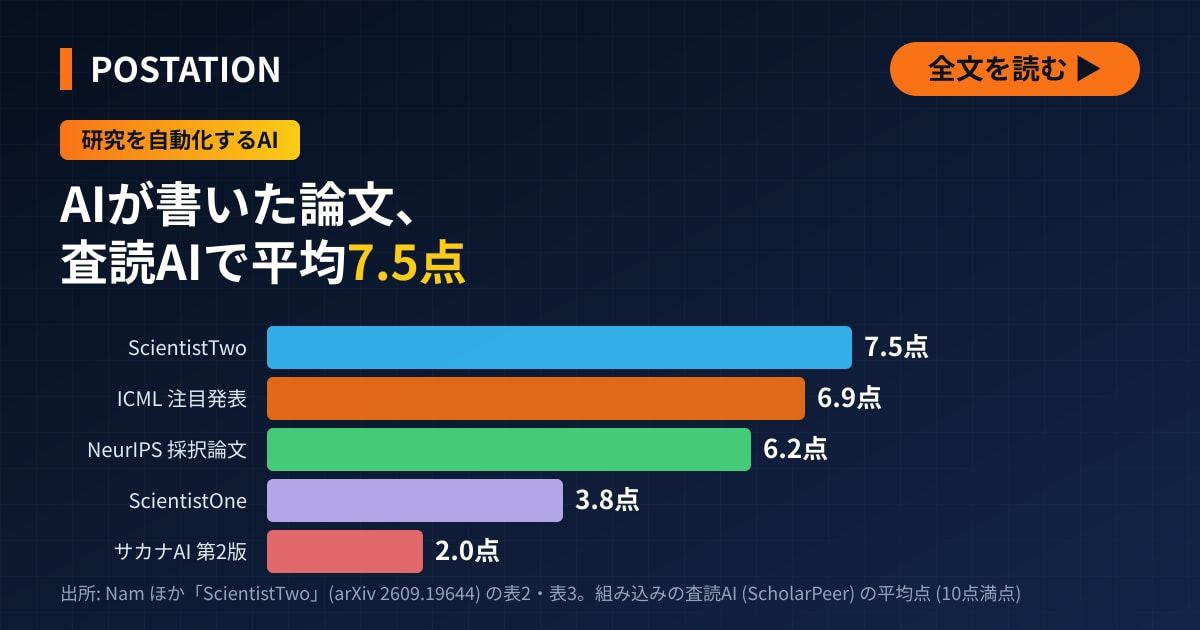
米グーグルの研究者らが開発した ScientistTwo は、機械学習の107課題中86課題で元の論文より優れた手法を見つけた。組み込みの査読AIは平均7.5点を付け、サカナAIの「AIサイエンティスト」第2版は2.0点だった。
グーグル・クラウドのAI研究部門などの研究者7人は9月17日、研究を自動で進めるAI「ScientistTwo」の論文を公開した。国際会議で採択された論文の課題を題材に、採択論文の手法より優れた手法を見つけられるかを試した。先行するサカナAIは2025年3月、同社のAIが書いた論文が国際会議に併設された会合で査読を通ったと発表している。編集部は論文の表の数字を検算し、SNS で広まった日本語の投稿の内容が論文と合うかを確かめた。
研究の全工程を6段階に分け、複数のAIエージェントが受け持つ
ScientistTwo は、役割を分けた複数のAIエージェントを組み合わせる仕組みだ。AIエージェントとは、人の指示を受けて自ら手順を組み立て、ほかのソフトを操作して作業をこなすAIを指す。研究チームによると、人が与えるのは最初の研究テーマだけで、その後は6段階を自動で繰り返す。
アイデアを出す段階では、現時点で最も性能が高い手法を調べて比較の基準とし、その弱点を補う案を出す。絞り込みの段階では、まず一部のデータで試し、有望な案だけを全データでの実験に回す。改良の段階では、実験の結果をもとに案を作り替え、最も優れたものを選ぶ。検証の段階では、手法の要素を1つずつ外して効き目を確かめる実験を自ら組み、役に立たない要素を削る。
執筆の段階では、原稿を書くと組み込みの査読AIが問題点を指摘する。指摘への対応を受け持つAIは、文章を直すだけでなく、追加の実験を組んで実際に動かす。最終判定の段階では、査読結果をまとめる役のAIが、採択に足る水準に届くまで作業を繰り返させる。時間と費用の大半を占めるのは、案の改良と、査読の指摘を受けた追加の実験だ。
ScientistTwo は2つの大規模言語モデルで動く。グーグルの Gemini 3.6 Flash と、米アンソロピックの Claude Opus 4.8 だ。プログラムを書く工程には、アンソロピックのプログラミング支援AI「Claude Code」を使った。この工程を、グーグルが自社で開発したプログラミング支援AI「Antigravity」に替えても試した。ICLR 2026 の5課題で、元の論文の手法を上回った課題は4件から3件に減った。上回った3件の性能の向上率は平均16.7%で、元の構成の4件の平均3.8%より高かった。ただ、2つの査読AIの点はどちらも下がった。
研究チームは ScientistTwo を、研究を手伝う道具ではなく、人類がまだ知らない領域を自ら切り開くAIだとしている。SNS の投稿は「博士号と科学研究全体を100%自動化」とうたうが、評価の対象は機械学習の研究課題に限られ、論文にそうした記述はない。
107課題中86課題で上回る、向上率の中央値は7.7%
課題は、実際に採択された論文が扱った問題と、公開されたプログラムから作った。NeurIPS 2025 の採択論文38本、ICLR 2026 の採択論文5本と、ICML 2026 の論文64本の計107本だ。ICML の64本は、注目発表 (スポットライト) に選ばれた論文だ。注目発表は、口頭発表に次いで評価の高い論文に与えられる発表の枠だ。
上回ったのは NeurIPS 2025 で38課題中33課題、ICLR 2026 で5課題中4課題、ICML 2026 で64課題中49課題だった。3会議の合計は107課題中86課題、割合は80.4%で、論文の表の値と一致する。
元の論文の手法と比べた性能の向上率は、上回った86課題の平均で25.2%だった。一方、中央値は7.7%だった。平均が中央値の3倍を超える (編集部の計算) のは、一部の課題で改善幅が大きく、平均を押し上げたためとみられる。別の研究チームが開発した同種の仕組み「AutoSOTA」は、既存のプログラムを調整して1つの指標だけを高める。AutoSOTA が元の論文の手法を上回った105課題の向上率は、中央値2.7%、平均7.5%だった。ScientistTwo の107課題も、AutoSOTA の評価に使われた論文から選んでいる。同じ課題で比べると、NeurIPS の33課題では ScientistTwo の方が高く、中央値7.0%、平均13.9%だった。AutoSOTA はそれぞれ3.7%、8.5%だった。ICLR の4課題では逆に AutoSOTA が中央値5.0%、平均7.2%と高く、ScientistTwo はそれぞれ2.2%、3.8%だった。
組み込みの査読AIの採点、サカナAIの第2版は2.0点
研究チームは、書き上げた原稿を2種類の査読AIに採点させた。まず組み込みの査読AI (ScholarPeer) の結果を見る。ScientistTwo の原稿86本は10点満点で平均7.5点を取り、91.9%が「採択」と判定された。同じ採点で、課題の元になった論文の平均は、ICML 2026 の注目発表が6.9点、ICLR 2026 が6.8点、NeurIPS 2025 が6.2点だった。
研究を自動化するこれまでのAIの原稿は、同じ採点で1.0〜3.8点だった。これらは各社が公開した原稿を採点したもので、同じ課題で比べたものではない。サカナAIの「AIサイエンティスト」第2版 (AI Scientist-v2) は、原稿3本の平均で2.0点だった。グーグルの研究者による前作 ScientistOne は21本の平均で3.8点だった。研究チームは先行研究として、サカナAIの初代と第2版を挙げる。初代は実験の実行が不安定で、原稿に事実と異なる記述が混じる問題があったと指摘する。第2版は、見込みの高い実験から順に試す方式などで、この問題を減らしたとしている。
サカナAIは2025年3月、国際会議 ICLR 2025 に併設された小規模な会合 (ワークショップ) に、第2版が書いた論文を3本投稿したと発表した。そのうち1本は、査読者3人の点が6点、7点、6点で、10点満点の平均6.33点となり、採択の目安を上回った。同社は、この点数が提出された全論文の約45%の水準に当たり、人が書いた採択論文の多くより高いと説明した。採択されても公開前に取り下げることを、同社は主催者と事前に取り決めていた。
外部の査読AIでは5.7点、専門家の評価は元の論文と「同等」
ScientistTwo の7.5点には注意が要る。研究チームは組み込みの査読AIを、ScientistTwo が執筆の段階で原稿を直すときの目安にも使っている。研究チームもこの点を認め、開発に一度も使っていない外部の査読AIにも採点させた。米スタンフォード大学が公開する査読AI (Agentic Reviewer) の採点では、ScientistTwo の平均は5.7点に下がった。「採択」と判定されたのは72.1%だった。それでも ICLR 2026 の採択論文 (5.2点) と NeurIPS 2025 の採択論文 (5.5点) を上回った。ICML 2026 の注目発表の論文 (6.1点、96.9%が「採択」の判定) には届かなかった。サカナAIの第2版はこの採点で2.5点だった。この採点で「採択」と判定された原稿は、これまでのAIでは1本もなかった。
専門家による評価もある。査読の経験がある専門家9人が、NeurIPS の課題から作った33本を5段階で採点した。研究の完成度や、最高峰の国際会議で採択される水準かを問う総合評価は3.7点で、6つの観点のうち最も低かった。元の論文と比べた評価は、3を「同等」とする5段階で、総合の観点が3.0点だった。観点別では、手法の厳密さだけが元の論文をわずかに下回った。研究チーム自身も、注目発表や口頭発表に選ばれる水準にいつも届くわけではないと認めている。
SNS の投稿は「引用の捏造が一つもない」とするが、これは ICML の課題から作った49本の点検結果だ。研究チームはプログラムを再実行して同じ数値を得られるか、課題の規則を破っていないかを確かめた。引用した文献が実在するか、手法の記述とプログラムが一致するかも調べた。49本すべてで数値を再現でき、規則を破ったプログラムはなく、引用1,814件に実在しない文献はなかった。記述とプログラムもすべて一致した。一方、引用、規則の順守、記述とプログラムの一致をそれぞれ点検する3つのAIを外して、原稿を作り直した。その50本では、引用1,840件のうち19件が実在しなかった。記述とプログラムが合わない原稿も11本あった。規則を破って評価指標の値を不正に高めたプログラムも1本あり、除外した。
1課題に平均2.5日、約59万円、改善を3回重ねた例も
費用も論文に記されている。NeurIPS の33課題で測ると、1課題に平均2.5日かかった。大規模言語モデルの利用料とクラウドの仮想サーバーの利用料を合わせて、平均3,765ドルだった。9月18日の円相場 (1ドル=156.87円、米連邦準備理事会の公表値) で換算すると約59万円になる。研究チームは、この費用のため、大学の研究室や個人の研究者には広がりにくい恐れがあるとした。企業が提供する非公開のモデルを、公開されたモデルに置き換えることなどを、今後の研究課題に挙げている。
研究チームは1つの課題で、ScientistTwo が自ら見つけた手法を出発点に改善を重ねられることを示した。題材は、AIが文章を扱うために単語より細かい単位に区切る処理を、文章が書き足されるたびに素早くやり直す課題だ。最初は元の論文の手法より性能を10.9%高め、次はその成果を土台に9.6%、さらに8.2%高めた。一方で研究チームは、学問の常識を覆すような発見はこれからの目標だとしている。
ScientistTwo の原稿は、開発に使っていない外部の査読AIでも採択論文並みの点を取った。ただ、採点したのはAIと専門家9人で、論文には実際の国際会議の査読を受けたという記述はない。サカナAIの事業はサカナAIの企業ページに、グーグルの親会社アルファベットの情報はアルファベットの企業ページにまとめている。AIエージェントの仕組みは、AI技術の体系解説 (エージェントの章)で解説している。
投資家向けの個別銘柄レポートと技術デューデリジェンスのご相談は、編集部のお問い合わせ窓口までお寄せください。












💬 この記事へのコメント 0
まだコメントはありません
最初のコメントを投稿してみましょう!⚠️ エラーが発生しました