Anthropicは最新AIモデル「Mythos」で演算カーネルを自動生成し、AMD製GPUへのモデル移植期間を従来の6〜12カ月からわずか3日間に短縮した。J.P.モルガンの集計でNvidiaの将来計算契約シェアは39%へ半減し、独占構造が崩れ始めている。
AnthropicのAIモデル「Mythos」がAMDへの移植期間を3日に短縮しCUDAの牙城を崩す
米国の最先端AI開発企業(フロンティアラボ)による半導体調達の構図が、2026年11月に入り根底から覆った。J.P.モルガン・アセット・マネジメントのマイケル・センバレスト氏が2026年11月14日に公表した調査レポート「Eye on the Market」は、AI半導体の競争環境と中国のオープンウェイト(重み公開型)企業に対するNvidiaの依存度を最重要の論点として取り上げた。同レポートの集計によると、フロンティアラボが締結した将来の計算資源契約(合計約41ギガワット[GW])のうち、Nvidia製GPUのシェアは39%(約16GW相当)にとどまった。2023年から2025年にかけて80%超の市場シェアを握っていたNvidiaの独占状態は、将来契約ベースで半減以下の水準まで後退した。
Nvidiaのジェンスン・フアン最高経営責任者(CEO)がオープンウェイトモデルの普及を熱心に擁護してきた背景にも、この構造変化がある。フロンティアラボ各社が自社設計チップや他社製半導体への移行を急ぐなか、Nvidiaは中国のモデル開発企業など新たな需要層を取り込まざるを得ない立場に置かれている。
本稿の図1が示す通り、約41GWに及ぶフロンティアラボの将来計算契約は5つの供給源に分散している。首位のNvidia製GPUが39%を占める一方、2位には米Broadcomが設計・供給を担うカスタム半導体(ASIC)が24%(約9.8GW相当)で続く。3位は米Googleの独自半導体「TPU」で16%(約6.6GW相当)、4位は米AMD製GPUで15%(約6.2GW相当)、5位は米Amazon Web Services(AWS)の独自チップ「Trainium」で6%(約2.5GW相当)となった。
アクセラレータ(CPUから計算負荷の高い専門処理を分離して高速実行する半導体)は、大量のデータを並列処理する汎用処理装置のGPUと、特定用途向けに回路を最適化したASIC(Google TPU、AWS Trainium、米Microsoftの「Maia」、米Metaの「MTIA」など)の2種類に大別される。これら3つのASIC陣営(Broadcomの24%、Googleの16%、AWSの6%)を合算すると46%に達し、Nvidia単独の39%を7ポイント上回る。さらに汎用GPUの2社(Nvidiaの39%とAMDの15%)の合算は54%であり、AI計算インフラの主戦場が「Nvidiaの1強」から「カスタムASIC連合とAMDを加えた多極体制」へ移行した事実が浮かび上がる。ハイパースケーラー(巨大クラウド事業者)5社とフロンティアラボ2社を合わせた大口需要家7社のうち、自社製チップの開発を試みていないのは米SpaceXの1社のみである。
この急激なシェア分散を引き起こした最大の技術要因が、Anthropicによるソフトウェア移植期間の劇的な短縮である。J.P.モルガンの同レポートおよびドイツのAI専門誌The Decoderの報道によると、Anthropicの共同創業者で最高計算責任者(Chief Compute Officer)を務めるトム・ブラウン氏は2026年11月、投資家向け説明において、同社の最新AIモデル「Mythos」を用いた半導体移行の実績を明らかにした。
わずか1年前の2025年時点では、Nvidiaのソフトウェア開発環境「CUDA」向けに書かれた大規模言語モデルをAMD製GPUへ移行(オンボード)して稼働させるまでに、数十人の専門エンジニアを投入して6〜12カ月の期間を要していた。多大な開発工数と費用がかかる煩雑な工程そのものが、Nvidiaの主張する「ワットあたりトークン生成性能とCUDAエコシステムの優位性により、他社チップへの乗り換えは経済的に引き合わない」という参入障壁の正体だった。
ところが現在、Anthropicは自社のAIモデル「Mythos」にエンジニアリング作業を担わせることで、わずか3日間で新モデルをAMD製GPU上にオンボードする体制を確立した。GPUの演算器を直接制御する低階層の小規模プログラムである「カーネル」について、Mythosがほぼ100%を自動で移植または新規に記述した。これまでAI半導体市場を支配してきたCUDAのロックイン(囲い込み)を、フロンティアラボ自身のAIモデルがわずか72時間で突破したことになる。
S-1修正報告書が明かす8,954億ドルの計算契約と売上対比コスト76%減の財務検算
Anthropicがなぜここまで執拗に複数メーカーの半導体を統合するのか。その理由は、同社が米国証券取引委員会(SEC)に提出した新規株式公開(IPO)目論見書(Form S-1および2026年11月2日付のS-1/A第1回修正報告書、11月10日付のS-1/A第2回修正報告書)の財務諸表と偶発債務の注記を精査することで明確になる。
S-1/A第1回修正報告書の損益計算書によると、Anthropicの2026年1〜9月期(9カ月累計)の売上高は前年同期の25億5,000万ドルから13倍となる332億4,000万ドルへ急拡大した。四半期ごとの売上高と「計算・インフラ費用(Compute and infrastructure cost)」の推移を時系列で検算すると、2026年第1四半期を境に収益構造が劇的に転換した事実が確認できる。
| 四半期 | 売上高(百万ドル) | 計算・インフラ費用(百万ドル) | 売上高に対する計算費比率(検算値) | 四半期営業損益(百万ドル) |
|---|---|---|---|---|
| 2025年第1四半期 | 376 | 944 | 251.1%(売上1ドルあたり2.51ドル) | 未開示(上期計-2,135) |
| 2025年第2四半期 | 787 | 1,390 | 176.6%(売上1ドルあたり1.77ドル) | 未開示(上期計-2,135) |
| 2025年第3四半期 | 1,382 | 2,047 | 148.1%(売上1ドルあたり1.48ドル) | 未開示 |
| 2025年第4四半期 | 2,040 | 2,945 | 144.4%(売上1ドルあたり1.44ドル) | 未開示 |
| 2026年第1四半期 | 4,731 | 3,387 | 71.6%(売上1ドルあたり0.72ドル) | -1,667(上期計から逆算) |
| 2026年第2四半期 | 11,555 | 5,558 | 48.1%(売上1ドルあたり0.48ドル) | +974(初の営業黒字) |
| 2026年第3四半期 | 16,956 | 9,863 | 58.2%(売上1ドルあたり0.58ドル) | -567 |
| 2026年1〜9月累計 | 33,242 | 18,808 | 56.6%(売上1ドルあたり0.57ドル) | -1,260 |
ここで1つ目の財務検算を行う。2025年上期(第1〜第2四半期合算)の売上高は11億6,300万ドル(3億7,600万ドル+7億8,700万ドル)、計算・インフラ費用は23億3,400万ドル(9億4,400万ドル+13億9,000万ドル)であり、売上1ドルあたりの計算費用は2.01ドルに達していた。すなわち、1ドルの売上を得るために2ドル以上の計算資源を消費する構造だった。これに対し、2026年第2四半期には売上高115億5,500万ドルに対して計算・インフラ費用が55億5,800万ドルとなり、売上1ドルあたりの計算費用は0.48ドルまで76.1%低下した。2026年上期(1〜6月期)の計算費用89億4,500万ドルの内訳を見ると、顧客向けの推論など直接収益を生む計算費用が約24億ドル、次世代モデルの事前学習や研究開発・無料枠の提供に充てられた費用が約65億ドルであった。稼働率の向上とマルチチップ化による調達単価の抑制が重なり、2026年第2四半期にはGAAP(米国会計基準)ベースで9億7,400万ドルの営業黒字(調整後営業利益では約22億ドル)を初めて計上した。
なお、2026年1〜9月期の最終損益(純損失)が1,040億4,000万ドルの巨額赤字となっている点についても会計上の仕組みを分解しておく必要がある。この純損失の90.7%にあたる943億2,000万ドルは、過去に発行した転換社債(Convertible Notes)や新株予約権付投資契約(SAFE)の公正価値評価損という非現金の会計処理によるものだ。Anthropicは転換社債(2026年6月末の貸借対照表計上額1,086億ドル)に公正価値オプションを適用しているため、同社の想定企業価値が2026年5月のシリーズH調達時(評価額9,650億ドル)からIPO想定時価総額(1兆〜1兆5,000億ドル規模)へと高騰するほど、帳簿上の負債評価額が膨らみ営業外費用として計上される。本業のキャッシュ創出力を示す2026年上期の営業キャッシュフローは39億2,900万ドルの黒字であり、設備投資(Capex)の4億8,200万ドルを差し引いたフリーキャッシュフローは約34億4,700万ドルのプラスに転換している。
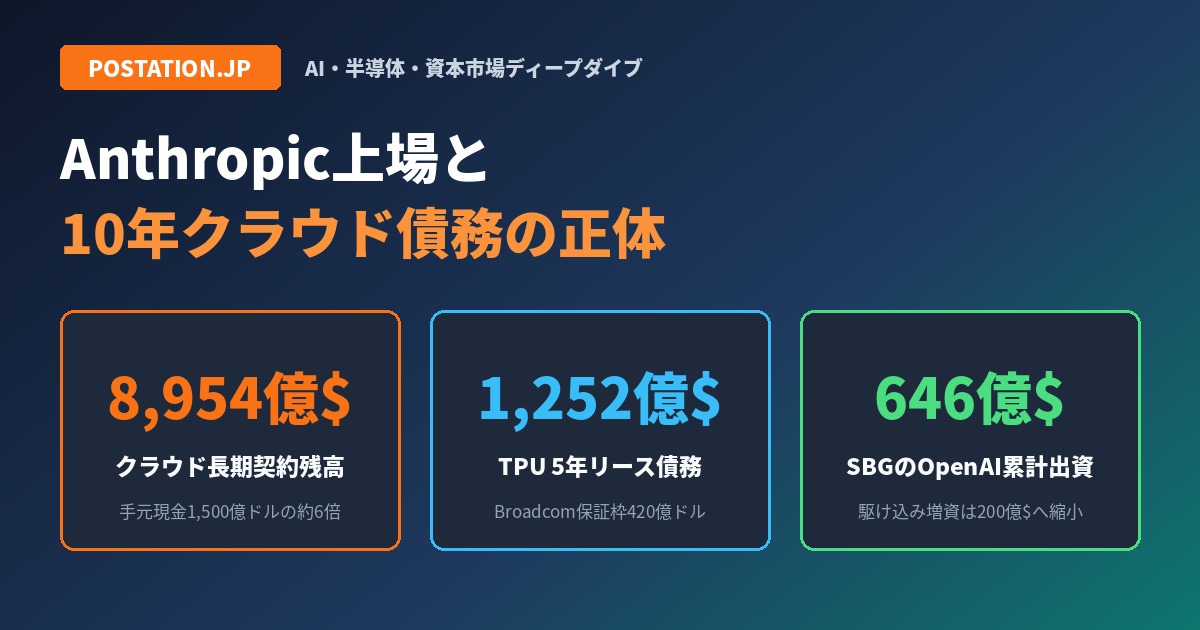
しかし、貸借対照表のオフバランス項目(注記のコミットメント表)には、前例のない規模の支払義務が刻まれている。ここで2つ目の財務検算を行う。2026年9月末時点でAnthropicが締結した将来の計算資源購入およびデータセンターリースの契約総額(コミットメント)は、約8,954億ドル(1ドル=150円換算で約134兆円)に達する。そのうち半分にあたる約4,475億ドルは2030年末までに支払期限が到来する。2026年6月末時点の分類内訳を検算すると、クラウド購入契約などに基づく固定・最低保証支払額が約2,656億ドル、未開始のデータセンターおよび計算設備リース契約の将来支払額が約3,214億ドルで、確定分だけでも合計5,870億ドルに上る。ロイター通信が報じた初期目論見書草案の段階では「今後10年間で少なくとも5,180億ドル(うち約80%が解約不能な最低支払保証付き)」とされていた契約群は、2026年4月から7月にかけての大型追加契約を経て、約8,954億ドルへと膨張した。
Broadcomの420億ドル年利9%融資枠と260億ドル同時私募が示す半導体6社の資本包囲網
約8,954億ドルという巨額の計算インフラ契約は、具体的にどの半導体・クラウド企業に振り分けられているのか。S-1報告書および各社の適時開示を時系列で突き合わせると、国内メディアがほとんど報じていない「半導体サプライヤーによる融資・残価保証」と「IPO同時私募(Concurrent Private Placement)による資本還流」という二重の幕裏工作が浮かび上がる。
Anthropicが2025年後半から2026年7月にかけて締結した主要6陣営との計算資源調達および資金移動の全体像は以下の通りである。
| 契約相手先・半導体種別 | 確保容量(GW)・規模 | 契約金額・最低支払保証(S-1および適時開示) | 幕裏の資本移動・融資・出資条件 |
|---|---|---|---|
| Amazon (AWS)(Trainium2 / 3 / 4・Graviton) | 最大5.0GW(2026年末に約1GW稼働) | 10年間で1,000億ドル超をAWS技術へコミット | 既存出資80億ドルに加え、2026年4月に50億ドル追加出資(将来最大200億ドルの追加出資枠で累計最大330億ドル)。6月末時点でAmazon保有の転換社債元本62億ドル。 |
| Google / Broadcom(次世代TPU Ironwood等) | 約3.5〜5.0GW(2027年以降順次稼働) | Googleへ最低1,111億ドル(2026年4月〜2033年7月、未使用でも差額支払義務)。Broadcom関連を含め最大2,000億ドル規模。 | BroadcomがTPUリース料支払専用の債券購入枠(融資枠)として最大420億ドル(年利9%)を設定。さらにBroadcomが630億ドルの銀行協調融資に対し機器の残価保証を供与。 |
| AMD(Instinct MI455X・Helios) | 最大2.0GW(2027年上期に最初の1GW) | 数百億ドル規模(S-1の個別契約合算6,370億ドルの一部) | 2026年7月に最大50億ドルの戦略投資枠を発表。さらに2026年11月のIPO同時私募で25億ドル(クラスN株式)を引き受け。 |
| Microsoft / Nvidia(Azure上のNvidia GPU) | 大規模クラスタ | 300億ドルのAzure計算資源購入契約(2025年11月締結) | IPO同時私募でNvidiaが100億ドル、Microsoftが10億ドルを引き受け。 |
| SpaceX (xAI)(Colossus 1・H100 22万基) | 0.3GW / 300MW(2026年稼働中・27年最大級へ) | 即時稼働枠として契約(Morningstar推計では2027年に最大級の供給元へ浮上) | 長期契約が稼働する2026年末〜2027年までの計算不足を埋めるブリッジ(つなぎ)容量として機能。 |
| IPO同時私募(7社連合)(クラスN普通株式の直接発行) | 該当なし(資本調達) | 総額260億ドル(2026年11月10日付 S-1/A第2回修正報告書) | Google 100億ドル、Nvidia 100億ドル、AMD 25億ドル、Broadcom 10億ドル、Microsoft 10億ドル、Micron 10億ドル、TSMC 5億ドル。 |
ここで3つ目の検算を行う。2026年4月に締結されたAWSとの 최대5GW契約(10年間で1,000億ドル超)は、1GWあたりの10年間コミットメント単価に換算すると約200億ドル(年間約20億ドル/GW)となる。一方、GoogleおよびBroadcomとの次世代TPU契約(3.5〜5GW、Google単独の最低支払保証1,111億ドル+Broadcomのリース枠)も、1GWあたり約220億〜300億ドルの設備・電力・リース費用が織り込まれている。
注目すべきは、S-1報告書で初めて判明したBroadcomによる金融スキームである。Anthropicは2026年6月末時点で現金・現金同等物(1,124億ドル)と短期投資(193億ドル)を合わせて約1,317億ドルの手元流動性を保有していたが、今後数年で数千億ドルのリース料・購入代金が発生する。これを支えるため、BroadcomはAnthropicに対して「TPUのリース料支払いのみに充当する最大420億ドルのノート・パーチェス・ファシリティ(債券購入枠、金利は年9%)」を供与した。さらにBroadcomは、銀行団や投資ファンドのBlackstoneなどがAI計算インフラ向けに組成する630億ドル規模のファイナンスにおいて、万一Anthropicの支払いが滞った場合でも半導体機器の担保価値を裏づける「残価保証(Residual value support)」を提供して信用リスクを補完している。
また、2026年11月10日に提出されたS-1/A第2回修正報告書(公開価格の仮条件を1株70〜78ドル、売出・公募株数を8億2,500万株と設定)では、IPOと同時に実施される総額260億ドルの第三者割当増資(同時私募、クラスN普通株式の発行)の内訳が開示された。その引受先は、Googleが100億ドル、Nvidiaが100億ドル、AMDが25億ドル、Broadcomが10億ドル、Microsoftが10億ドル、メモリ大手の米Micron Technologyが10億ドル、製造受託の台湾TSMCが5億ドルの計7社である。
一方、サプライヤー側のNvidia自身の財務諸表にも異変が起きている。Nvidiaの2027会計年度第2四半期(2026年7月26日終了)のForm 10-Q(四半期報告書)を検算すると、過去3四半期において営業キャッシュフローの58%が顧客企業への株式出資や買収(さらにはデータセンター事業者への融資保証)に費やされた。同四半期末におけるNvidiaのオフバランス債務(製造委託や部材調達の購入コミットメント3,660億ドル+追加コミットメント560億ドル)の合計は4,220億ドルに達し、前四半期の2,144億ドルからわずか3カ月間で約2倍に急増した(加えて最大保証エクスポージャーが1,085億ドル存在する)。
つまり、NvidiaもBroadcomもAMDも、自社の半導体を買わせるために巨額の出資金や年利9%の融資枠をAnthropicに提供している。Anthropicの経営陣から見れば、もしNvidiaのCUDAだけに100%依存していれば、73〜75%に達するNvidiaのデータセンター部門売上総利益率(粗利率)をそのまま支払わされる立場にあった。しかし、MythosによってAMD製GPUやGoogle TPU、AWS Trainiumへの移植コストを「3日間」へ極小化したことで、4系統のチップを「代替可能な1つの計算プール(Fungible compute pool)」として束ね、半導体メーカー同士を競わせて出資金と価格譲歩を引き出す交渉力を手に入れたのである。
AMD「MI455X」の2nmチップレット構造と日本の半導体部材・製造装置に落ちる大型需要
なぜAnthropicは、Mythosによる3日間の移植先としてAMD製GPUを最優先の柱に据えたのか。J.P.モルガンのレポートは、2027年にNvidiaが投入する次世代機「Rubin Ultra」シリーズが再び状況を変える余地を残しつつも、現時点(2026年11月)では「チップ1基あたりの推論性能指数(Inference performance index per chip)でAMDがトップに立っている」と明記した。
推論性能指数とは、単なる1秒あたりの算術演算回数(FLOPS)ではない。大規模言語モデルの推論(特に入力プロンプトを処理するPrefill工程と、トークンを逐次生成するDecode工程)では、演算器の計算速度以上に「高帯域幅メモリ(HBM)の容量・帯域幅」と「チップ間の通信速度(インターコネクト)」が処理速度を決定づける。モデルの重み(パラメータ)と文脈データ(KVキャッシュ)をメモリから演算器へ毎秒何テラバイト転送できるかが、1ワットあたりのトークン生成量と1GWあたりの総保有コスト(TCO)を左右するためである。
Anthropicが最大2GWの導入を決めたAMDの次世代GPU「Instinct MI455X」およびそれを72基搭載するラックスケールシステム「Helios」の物理構造を解剖すると、推論性能で首位に立った技術的根拠が分かる(本稿の図2)。
AMDが2026年7月の「Advancing AI 2026」で発表した技術仕様によると、Instinct MI455Xは第5世代の「CDNA 5」アーキテクチャを採用し、以下の4つの技術的急所を持つ。
- TSMC 2nmプロセス(N2)の業界初採用と12チップレット構成: 演算を担うメインのアクセラレータ複合ダイ(XCD)に、業界で初めてTSMCの2nmプロセス(N2、ナノシートGAAトランジスタ構造)を採用した。1パッケージ内にAMD製のチップレット12個と、HBM4(第6世代高帯域幅メモリ)のメモリダイ合計144個(12スタック)を高密度に収めている。総トランジスタ数は3,200億個に達する。
- 3D積層「SoIC」によるL2キャッシュの6倍拡張: 先代機の「Instinct MI355X」ではL2キャッシュメモリが演算ダイ(XCD)の内部に置かれていたが、MI455XではTSMCの3次元シリコン積層技術「SoIC(System-on-Integrated-Chips)」を用い、下層のファブリック複合ダイ(FCD)へL2キャッシュを分離・移動させた。これにより、パッケージ全体のL2キャッシュ容量はMI355Xの32MBから6倍となる192MBへ拡大し、演算器へのデータ供給の詰まり(メモリウォール)を解消した。
- HBM4による432GB容量と毎秒23.3TBのメモリ帯域幅: 搭載メモリはHBM3E(288GB、帯域幅8TB/秒)から次世代の「HBM4」へ進化し、1基あたりのメモリ容量は1.5倍の432GB、メモリ帯域幅は約2.9倍の毎秒23.3TBに達した。700億〜数千億パラメータの巨大モデルを推論する際、Nvidiaの現行世代よりも少ないGPU枚数でモデル全体をメモリ内に収容できるため、チップ間通信の遅延を最小化できる。
- Broadcom製UALinkスイッチを用いた「Helios」ラック(72基連結): AMDはMI455Xを1ラックに72基実装した「Helios」を生産開始した。72基合計で31TBのHBM4を搭載し、MXFP4(4ビット浮動小数点)演算時のスループットは2.9エクサフロップス(EFLOPS)、FP8演算時は1.4EFLOPSに達する。これはNvidiaの対抗機「Vera Rubin NVL72」(FP8学習時1.26EFLOPS、NVFP4学習時2.52EFLOPS)に匹敵または凌駕する水準である。さらにラック内のスケールアップ通信には、Nvidia独自の「NVLink」に対抗するオープン規格「UALink(Ultra Accelerator Link)」を採用し、Broadcom製のUALinkスイッチトレイで72基を直結している。
ここで日本の投資家とエンジニアが見落としてはならない産業構造上の急所がある。フロンティアラボの将来計算契約(約41GW)において、Nvidia(39%)からBroadcom(24%)、Google TPU(16%)、AMD(15%)、AWS Trainium(6%)へとシェアがどれだけ分散しようとも、これらすべての先端AI半導体が共通して通過しなければならない製造工程のボトルネックを、日本の上場企業が独占的に握っているという事実である。
第1の急所は、TSMCの2次元再配線パッケージ技術「CoWoS-L」および3次元積層「SoIC」を支える超大型パッケージ基板(FC-BGA基板)と層間絶縁材である。AMDのMI455Xのように12個の演算ダイと12個のHBM4スタックを1つのパッケージに統合する場合、シリコンインターポーザの下で全体を支えるパッケージ基板の面積は従来比で数倍に大型化し、高多層化(20層以上)による反り(Warpage)の抑制が歩留まりを決定づける。このAIサーバー向け超大型FC-BGA基板で世界首位のシェアを持つのがイビデン(証券コード:4062)である。イビデンはNvidiaのBlackwellやRubin向けだけでなく、AMDのInstinctシリーズやクラウド各社のカスタムASIC(Broadcom・Google・AWS)向けの最先端基板を一手に供給しており、大垣中央事業場や河間事業場での巨額増産投資がそのまま約41GWの計算契約の受け皿となっている。また、すべてのFC-BGA基板の微細配線層に不可欠な層間絶縁フィルム「ABF(味の素ビルドアップフィルム)」は、味の素(2802)が世界シェアほぼ100%を握っている。
第2の急所は、144個のメモリダイを積層するHBM4の後工程(モールディング装置・封止材・ダイシング装置)である。J.P.モルガンが指摘した通り、推論性能指数を引き上げる鍵はHBM4の搭載量(Helios 1ラックあたり31TB)にある。AnthropicがNvidiaを買おうがAMDのMI455Xを買おうが、あるいはBroadcom経由でGoogleの次世代TPUを3.5GW導入しようが、1GWあたりのHBM消費量は増え続ける。HBMの12層〜16層積層工程でチップ間の隙間を樹脂で精密に埋めるコンプレッション方式のモールディング装置ではTOWA(6315)が世界シェア首位を走り、非導電性フィルム(NCF)や封止材・ダイボンディング材ではレゾナック・ホールディングス(4004)と住友ベークライト(4203)が中核部材を供給している。さらに、シリコンウエハーやガラスキャリアを極薄に研削・切断するグラインダ・ダイシング装置ではディスコ(6146)が圧倒的なシェアを持ち、HBM4とCoWoS-Lのテスト工程ではアドバンテスト(6857)のSoC・メモリテスタが不可欠となる。
米中規制で揺れるNvidiaのオープンウェイト戦略と単一計算プールが変える供給網の未来
米中間の半導体輸出管理とグローバル供給網の視点からこの構造変化を捉え直すと、J.P.モルガンのレポートが掲げた表題「アクセラレータの競争環境と中国のオープンウェイト企業に対するNvidiaの依存」の真意が浮き彫りになる。
米国の最先端AI開発企業(AnthropicやOpenAI)および巨大クラウド事業者は、1GWあたりの総保有コスト(TCO)を引き下げるため、特定ベンダーへの依存を脱し、Broadcom・Google・AWSのカスタムASIC(計46%)とAMD製GPU(15%)へ調達の大半を移した。これまでNvidiaを最大の顧客として支えてきた米国のフロンティアラボが「足による投票(実際の調達行動による離反)」を進めた結果、Nvidiaは売上高と70%超の粗利率を維持するために、自社でカスタムASICを持たずオープンウェイトモデルを開発する中国系AI企業や各国のソブリンAI(国家主導のAIインフラ)への販売に頼らざるを得ない構造に追い込まれている。しかし、中国向けには米国商務省産業安全保障局(BIS)による先端AI半導体およびHBMの輸出規制という地政学上の天井が常に存在する。
対照的に、Anthropicは自社のAIモデル「Mythos」によってCUDAのソフトウェア障壁を3日間で突破し、Nvidia GPU、AMD GPU、Google TPU、AWS Trainiumという4系統の異なるアーキテクチャを単一の「代替可能な計算プール」へと変貌させた。約8,954億ドルに及ぶ長期コミットメントを背負いながらも、ワークロードの特性(事前学習、プロンプト処理のPrefill、トークン生成のDecode)に応じて1ドルあたりの計算量が最大化する半導体へ自在に処理を振り分ける体制を完成させている。
AI半導体の覇権は、CUDAという単一のソフトウェア城壁で超過利潤を独占する時代を終え、AIモデル自身がカーネルを書き換えて複数チップを使いこなす「ハードウェア抽象化と物理パッケージング技術」の競争へと完全に移行した。米国のAI開発企業と半導体メーカーが巨額の資本還流とシェア争いを繰り広げるなか、TSMCの2nmプロセスとCoWoS-L、そしてHBM4の物理的な積層限界を支えるイビデン、味の素、レゾナック、TOWA、ディスコ、アドバンテストといった日本の半導体部材・製造装置企業こそが、41GW超の次世代計算インフラ投資の果実を最も確実に享受する位置に立っている。
投資家向けの個別銘柄レポートと技術デューデリジェンスのご相談は、編集部のお問い合わせ窓口までお寄せください。





💬 この記事へのコメント 0
まだコメントはありません
最初のコメントを投稿してみましょう!⚠️ エラーが発生しました