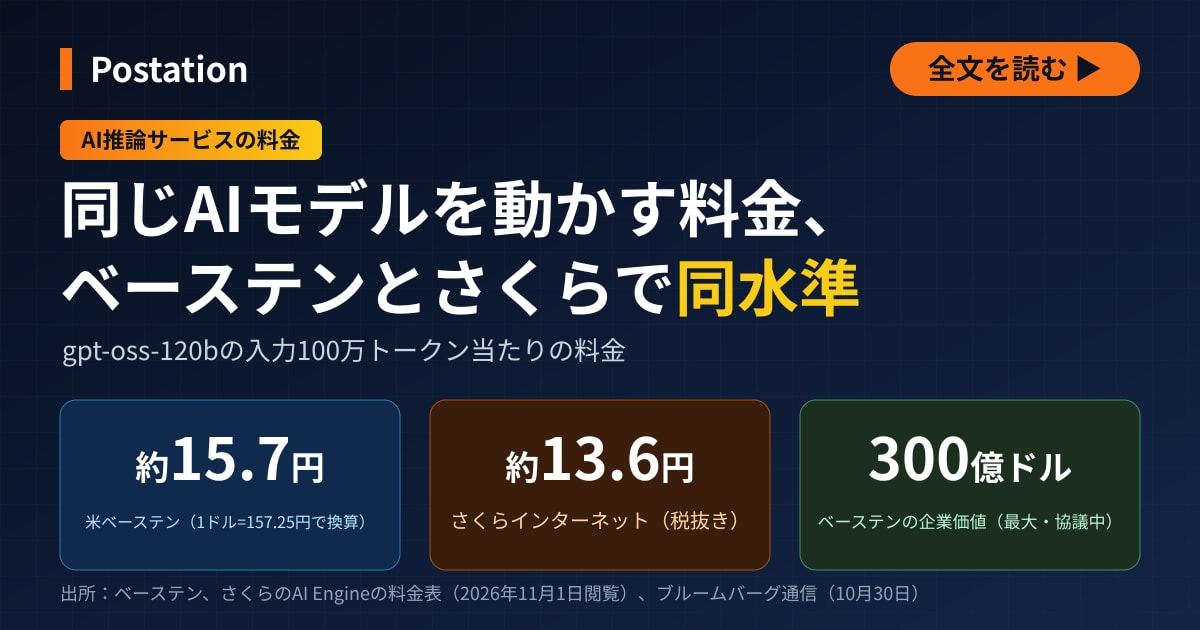
米オープンAIが公開した言語モデル「gpt-oss-120b」を動かす推論サービスの料金は、米新興企業のベーステンとさくらインターネットでほぼ同じだ。入力100万トークン当たりでは両社とも15円前後で、税抜きではさくらが1割強安い。
推論とは、学習済みのAIモデルを使い、質問への回答を生成する処理を指す。トークンは、AIが文章を処理する際の最小単位だ。推論サービスを手がけるベーステンは、企業価値を最大300億ドルと評価する資金調達を協議している。さくらインターネットは10月28日、GPU (画像処理半導体) をクラウド経由で貸し出すサービスが好調だとして、2027年3月期の業績予想を上方修正した。
ベーステン、企業価値最大300億ドルで約20億ドルの調達を協議
米ブルームバーグ通信は10月30日、ベーステンが約20億ドルの資金調達に向けて協議していると報じた。関係者によると、調達は2つに分かれ、企業価値はそれぞれ260億ドル、300億ドルと評価される。既存株主の米投資会社サンズ・キャピタルが出資を主導する見通しだが、条件はまだ固まっていない。米ニュースサイトのアクシオスは9月22日、ベーステンが企業価値260億ドルで資金調達を協議していると報じていた。ベーステンは2019年設立で、米サンフランシスコに本社を置く。
ベーステンは6月22日、「シリーズF」と呼ぶ資金調達で15億ドルを集めたと発表した。発表文によると、出資は2つに分かれ、企業価値はそれぞれ130億ドル、110億ドルと評価されていた。今回の調達が企業価値300億ドルでまとまれば、6月の130億ドルの約2.3倍になる。6月の調達は、米投資会社のアルティメーター・キャピタル、コンビクション、スパーク・キャピタル、サンズ・キャピタルと、米資産運用会社のウェリントン・マネジメントの5社が主導した。ベーステンによると、シリーズFは過去1年半で4回目の資金調達だった。調達した資金は人材の採用や計算資源の確保、企業向けの営業体制の強化に充てる。
ベーステンは1月23日にも、「シリーズE」で3億ドルを調達したと発表していた。企業価値は50億ドルと評価され、この調達には米エヌビディアも出資した。米紙ウォール・ストリート・ジャーナルによると、エヌビディアの出資額は1億5000万ドルだった。同社が今回の調達にも出資するかどうかは明らかになっていない。エヌビディアがどの企業に出資し、その投資でどれだけ利益を上げているかは、同社が米証券取引委員会に提出した保有株式の報告書を分析した記事で詳しく取り上げた。
同業の米ファイアワークスAIは7月16日、「シリーズD」で約15億ドルを調達したと発表した。増資後の企業価値は175億ドルで、年換算の売上高は10億ドルを超えたという。
gpt-oss-120bを使う推論サービスの料金、税抜きではさくらインターネットがベーステンより1割強安い
gpt-oss-120bは、オープンAIが2025年8月に公開した言語モデルだ。モデルの性能を左右するパラメーターまで公開されており、「Apache 2.0」というライセンスの条件を守れば、誰でも自前のGPUで動かせるうえ、商用にも使える。こうしたモデルは「オープンウエート」と呼ばれる。ベーステンとさくらは、このモデルを使った推論サービスを従量課金で提供している。
| 100万トークン当たりの料金 | 入力 | 出力 |
|---|---|---|
| さくら (税込み) | 15円 | 75円 |
| さくら (税抜き) | 約13.6円 | 約68.2円 |
| ベーステン (税抜き) | 0.10ドル | 0.50ドル |
| ベーステン (円換算) | 約15.7円 | 約78.6円 |
ベーステンの料金は11月1日時点の同社の料金表による。円換算には10月30日の欧州中央銀行の参照レート (1ドル=157.25円) を使った。さくらは推論サービス「さくらのAI Engine」の料金を1万トークン当たり (税込み) で公表しているため、表では100万トークン当たりに換算した。
税抜きで比べると、さくらはベーステンより約13%安い。1ドル=136円程度まで円高・ドル安が進めば、この差はなくなる。
トークン単位の料金、GPUの利用料から逆算か
gpt-oss-120bのパラメーター数は約1170億だが、1トークンの処理に使うのは約51億にとどまる。内部に多数の専門モデルを持ち、トークンごとにその一部だけを選んで動かす仕組みのためだ。パラメーターの大半を「量子化」という手法で1つ当たり約4ビットに圧縮しているため、モデルはメモリー容量が80ギガバイトのGPU1枚で動く。その結果、推論にかかる費用はおおむねGPUの利用料で決まり、トークン単位の料金もGPUを1時間使う費用から割り出しやすい。
ベーステンは、顧客ごとにGPUを割り当てるサービスも提供しており、こちらは利用時間に応じて1分単位で課金する。エヌビディアのGPU「H100」を使う場合の料金は、1時間当たりに換算すると約6.5ドルになる。この額を出力100万トークン当たりの料金である0.50ドルで割ると、約1300万トークン分になる。GPU1枚が1時間に約1300万トークンを出力すれば、トークン単位で課金した場合の収入が、GPUを1時間貸した場合と同じになる計算だ。
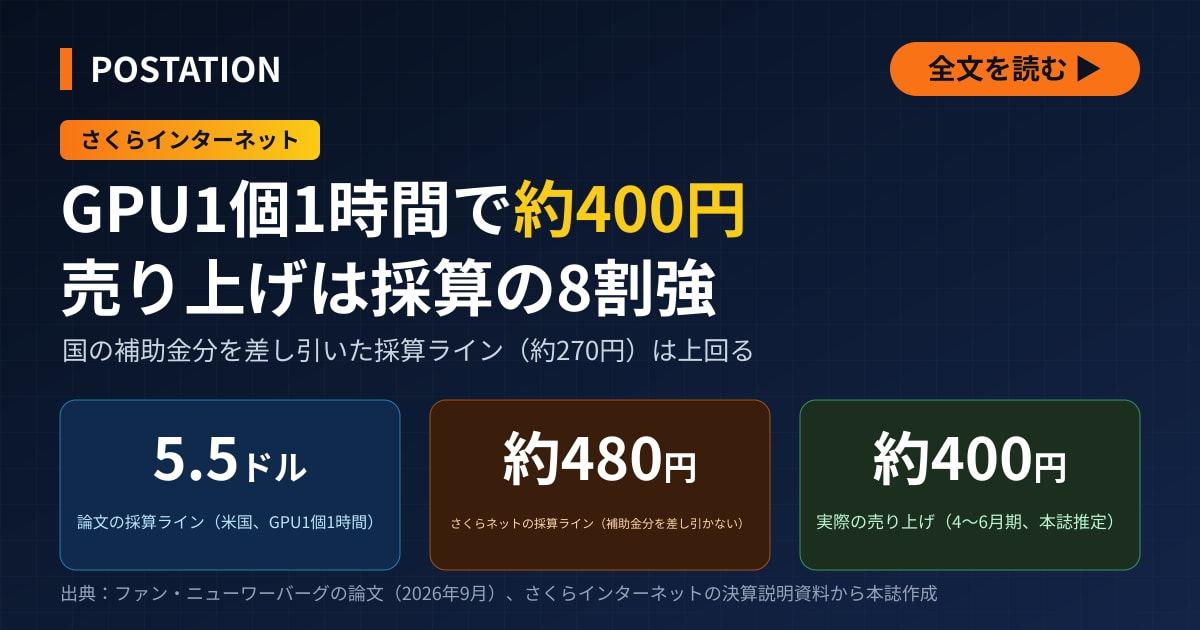
さくらインターネットはGPUクラウド「高火力 VRT」で、H100を1時間当たり990円 (税込み) で貸し出している。この額を出力100万トークン当たりの料金である75円 (税込み) で割ると約1320万トークン分となり、ベーステンとほぼ同じ水準だ。1時間当たりの料金を税抜きで比べると、さくらが900円、ベーステンが円換算で約1,020円となり、さくらのほうが約12%安い。トークン単位の料金でもさくらのほうが約13%安く、差はほぼ同じだ。両社とも、GPUを1時間貸す価格からトークン単位の料金を逆算して決めているとみられる。
1時間に約1300万〜1320万トークンを1秒当たりに換算すると、約3,600〜3,700トークンになる。GPU1枚がこれを上回る量を出力できれば、時間単位で貸すよりもトークン単位で売るほうが収入は多くなる。入力トークンの料金も収入に含めれば、必要な出力の量はさらに少なくて済む。推論サービスを手がける企業の収益力は、GPU1枚で出力できるトークンの量で大きく変わる。出力できる量は、多くの利用者の要求をまとめて処理する技術や、GPUの計算を速めるソフトウエアの性能に左右される。これらの数字は料金表から試算した目安で、GPU1枚が実際に処理しているトークンの量は両社とも開示していない。
ベーステンは顧客が追加学習させたAIモデルの運用、さくらインターネットは国内でのデータ処理を売りに
ベーステンは、企業が使うAIモデルをクラウド上で動かすサービスを提供している。6月の発表によると、1日に処理する推論は10億回を超える。推論には、クラウド事業者18社が提供する計87のGPUクラスター (多数のGPUをつないだ計算設備) を使っている。6月までの1年で、売上高は約20倍に、推論の処理量は40倍に増えた。
顧客には、プログラミング支援ソフト「カーソル」を開発する米エニースフィアや、文書作成・共有ソフトの米ノーションが名を連ねる。顧客管理ソフトの米ハブスポットや、営業の見込み客となる企業の情報を集めるソフトを手がける米クレイも利用している。
ベーステンは、顧客企業が独自に追加学習させたAIモデルの運用に力を入れている。トゥーヒン・スリバスタバ最高経営責任者 (CEO) は6月の発表で、AIモデルの追加学習は企業にとって「死活問題になった」と述べた。同社によると、AIを組み込んだサービスを手がける有力企業は、AIモデルにかける費用の3〜5割をこうした独自のモデルに充てている。
追加学習させたモデルの良しあしは、顧客企業の製品の品質に直結する。顧客企業がモデルの運用を一度任せると、他社に移す際に応答の速さや安定性を改めて確かめる必要があり、乗り換えは容易ではない。ベーステンは自社のブログで、オープンウエートのモデルは性能が上がり、パラメーターを公開していないモデルから企業が切り替えられる水準に達したとの見方を示した。同社には、オープンウエートのモデルを従量課金で提供して利用者を集め、顧客企業が追加学習させたモデルの運用を請け負うことで長期の取引につなげる狙いがあるとみられる。
さくらは、データを国外に出さずにAIを使える点を売り込む。同社は2025年9月24日、複数のAIモデルをネット経由で呼び出して使える「さくらのAI Engine」の提供を始めた。無料枠でも月3,000回まで文章を生成できる。2026年8月4日には、AI開発のプリファード・ネットワークスの大規模言語モデル (LLM)「PLaMo 3.0 Prime」も使えるようにし、国産LLMを国内のデータセンターだけで動かせる点を強調した。
10月8日には「さくらのAI Engine プライベートエディション」の提供を始めた。企業が持ち込んだAIモデルをその企業専用のGPUで動かし、社内のシステムなどから利用できるようにするほか、運用や監視も請け負う。仕組みは、ベーステンが顧客ごとにGPUを割り当てるサービスに近い。ベーステンが1分単位で課金するのに対し、さくらはGPU単位の月額の定額料金とし、金額は公表せずに個別に見積もる。処理はすべて国内のデータセンターで行い、利用者が入力したデータやAIの回答は保存せず、学習にも使わないとしている。さくらは提携先を通じた販売も広げており、6月に刷新したパートナー制度には10月21日時点で80社が参加している。
さくらインターネット、GPU事業の今期売上高を前期の約2.6倍と見込む
さくらが10月28日に発表した2026年4〜9月期の連結決算は、売上高が前年同期比46%増の228億円だった。営業損益は29億円の黒字 (前年同期は9億2000万円の赤字) に転じた。同社は2027年3月期の連結業績予想も上方修正し、売上高は前期比32%増の466億円を見込む。営業損益は41億円の黒字 (前期は4億円の赤字) に転じる見通しだ。
GPUを貸し出す事業が増収をけん引した。GPU事業の今期の売上高は、前期の約2.6倍にあたる208億5000万円になる見通しだ。同社によると、エヌビディア製の「H100」「H200」「B200」はほぼフル稼働で、GPUの貸し出し料金も上がった。GPUサーバーは3年で減価償却しており、2027年1月以降、償却が順次終わる。さくらは決算説明資料で、GPUは学習から推論まで幅広い用途に使えると説明している。ただ、売上高のうち学習向けと推論向けの内訳や、「さくらのAI Engine」の売り上げは開示していない。
投資家から資金を集めるベーステンに対し、さくらはGPUの調達に国の助成金を活用している。経済産業省は2024年4月15日、経済安全保障推進法に基づき、さくらがGPUを使うクラウド基盤の整備に約1,000億円を投じる第2次計画を認定した。GPUを約8,000基購入する計画で、経産省の助成は最大約501億円と、同時に認定した5件の中で最も多い。2023年に認定された第1次計画と合わせると、投資額は合計1,130億円になる。このうち2026年3月期までに521億円を投じた。同社は2026年7月、エヌビディアの新型GPU「ルービン」などの導入に260億円を投資することも決めた。
推論サービスの料金はほぼ同じでも、ベーステンは顧客が追加学習させたモデルの運用を、さくらはデータを国内にとどめられる企業専用のサービスを前面に打ち出す。
投資家向けの個別銘柄レポートと技術デューデリジェンスのご相談は、編集部のお問い合わせ窓口までお寄せください。







💬 この記事へのコメント 0
まだコメントはありません
最初のコメントを投稿してみましょう!⚠️ エラーが発生しました