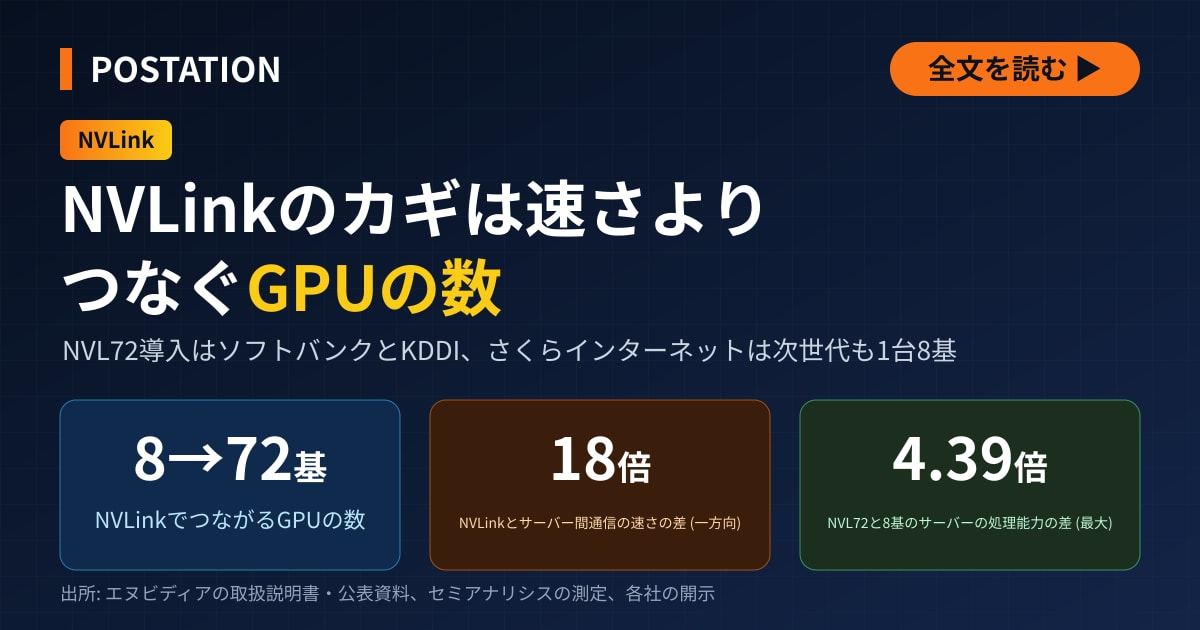
エヌビディアの接続技術「NVLink」は毎秒1.8テラバイトの転送速度で紹介されるが、推論の性能を左右するのはつながるGPUの数だという指摘がある。NVL72は従来の9倍の72基をつなぐ。日本の9社で導入を確認できたのは2社だ。
米エヌビディアは、自社のGPU同士をつなぐ独自の接続技術「NVLink」のデータ転送速度を、GPU1基あたり毎秒1.8テラバイトとしている。NVLinkで最も大事な数字は転送速度ではなく、NVLinkでつながるGPUの数である「72」だ。AI向けの計算基盤を英語で解説している技術者が、投稿でこう指摘した。本稿はこの主張が正しいかを確かめた。使ったのは、エヌビディアの取扱説明書と公式ブログ、中国のAI企業ディープシークの論文、米調査会社セミアナリシスの測定結果だ。日本企業が使っているのが従来の8基のサーバーかNVL72かは、各社の開示資料で調べた。
NVLinkでつながるGPUは従来の8基からNVL72で72基に
NVLinkでつながったGPU同士は、互いのメモリーにあるデータを高速にやりとりできる。エヌビディアは2025年6月の公式ブログで、ラック単位の製品「GB200 NVL72」の登場前は、NVLinkでつながるGPUの上限が8基だったと説明している。8基は、同社のGPU用の基板「HGX」1枚に載る数だ。HGX H100とHGX H200は、GPU8基と、GPU間をつなぐ専用の半導体 (スイッチチップ) 4個を1枚の基板に搭載する。ブラックウェル世代のサーバー「DGX B200」も、GPU8基とスイッチチップ2個からなる。
8基を超えるGPUをNVLinkでつなぐ製品は、NVL72より前にもあった。エヌビディアは2022年、H100を最大256基つなぐ仕組みを発表した。2023年には、GH200を256基つないだ「DGX GH200」も発表している。本稿は同社の説明に従い、NVL72より前の上限を8基とする。
サーバーの外にあるGPUとは、NVLinkではなく、通信規格「インフィニバンド」やイーサネットのネットワークを通じて通信する。このサーバー間通信の速さは、DGX B200ではGPU1基あたり毎秒400ギガビットだ。
GB200 NVL72は、NVLinkでつながる範囲をラック (サーバーを収める棚) 1台分に広げた製品だ。取扱説明書によると、ラックには、GPU4基とCPU2基を載せた装置18台と、NVLinkの通信を中継するスイッチ9台が入る。スイッチにはスイッチチップが2個ずつ載り、ラック全体で18個になる。GPUを載せた装置同士はスイッチを通じてNVLinkで通信し、サーバー間通信のネットワークは使わない。こうして、72基のGPUがラックの中でNVLinkだけで互いにデータをやりとりできる。ネットワークを使うのは、ラックの外にあるGPUと通信する場合に限られる。
エヌビディアは、ラック全体のNVLinkの速さを毎秒130テラバイトとしている。72基それぞれの毎秒1.8テラバイトを単純に足すと毎秒129.6テラバイトになり、130テラバイトはこの合計にほぼ等しい。ラックの外との通信の速さは、GPU1基あたりでGB200のラックが毎秒400ギガビット、後継のGB300のラックが毎秒800ギガビットだ。ラックやサーバーの基本的な仕組みは、当サイトのAI計算資源の解説 (設備)で説明している。
NVLinkの毎秒1.8テラバイトは双方向の値、一方向で比べればサーバー間通信の18倍
ブラックウェル世代のNVLinkについて、エヌビディアは毎秒1.8テラバイトを「双方向」の値と明記している。送信と受信を合わせた速さだ。GPU1基には18本のNVLinkがつながる。1本あたりの速さは双方向で毎秒100ギガバイト、送信だけ (一方向) では毎秒50ギガバイトだ。18本を合わせると、GPU1基あたり一方向で毎秒900ギガバイトになる。
サーバー間通信の速さはGPU1基あたり毎秒400ギガビットで、8で割ってバイトに換算すると、一方向で毎秒50ギガバイトにあたる。一方向の値で比べると、NVLinkの速さはサーバー間通信の18倍だ。投稿者は、この18倍は説明のための概算で、実際に測った値ではないと断っている。
よく引用される「36倍」は、この2倍にあたる。双方向の合計である毎秒1.8テラバイトを、一方向の毎秒50ギガバイトで割った数字だ。エヌビディア自身も、2025年6月の公式ブログで「毎秒400ギガビットのイーサネットの36倍」と記している。一方、ディープシークは2025年に国際学会で発表した論文で、GB200 NVL72のNVLinkの速さを一方向で毎秒900ギガバイトとして計算している。この値をサーバー間通信の速さと比べると、差は18倍になる。
表1 GPU1基あたりの速さ (一方向、毎秒ギガバイト) とNVLinkでつながるGPUの数
| 製品 | NVLink | サーバー間通信 | 速さの差 | NVLinkでつながるGPU |
|---|---|---|---|---|
| DGX H100 | 450 | 50 | 9倍 | 8基 |
| DGX B200 | 900 | 50 | 18倍 | 8基 |
| GB200 NVL72 | 900 | 50 | 18倍 | 72基 |
| GB300 NVL72 | 900 | 100 | 9倍 | 72基 |
| Vera Rubin NVL72 | 1,500〜1,800 | 200 | 7.5〜9倍 | 72基 |
出所: エヌビディアの製品ページ・取扱説明書・公式ブログ (2026年10月4日に確認)。一方向の値と速さの差は本稿の計算。NVL72の「サーバー間通信」はラックの外との通信の値。Vera Rubin NVL72のNVLinkの値は、本文に記した2つの公表値から計算した。
NVLinkとサーバー間通信の速さの差は、表1ではDGX B200とGB200の18倍が最も大きく、その後は縮んでいる。GB300ではサーバー間通信が毎秒800ギガビットに速くなり、差は9倍になった。次世代のVera Rubin NVL72は、サーバー間通信の速さをGPU1基あたり毎秒1.6テラビットに高める。
Vera RubinのNVLinkの速さは、2026年1月の発表時点でGPU1基あたり双方向で毎秒3.6テラバイトだった。エヌビディアは9月、NVLinkの製品ページの表記を毎秒3テラバイトに改めた。同ページは数値を暫定値としている。同社の公式ブログなどは3.6テラバイトのままだ。変更の理由を説明した資料は見当たらなかった。一方向に直すと、毎秒3テラバイトは1.5テラバイト、3.6テラバイトは1.8テラバイトで、サーバー間通信との差は7.5倍と9倍になる。
NVLinkでつながるGPUの数は、Vera Rubin NVL72まで72基で変わらない。エヌビディアはその次のRubin Ultraについて、GPU72基を載せたラック8台をNVLinkでつなぎ、576基を1つのコンピューターとして動かす構成も示している。表1に挙げた値で比べると、DGX B200とGB200 NVL72はNVLinkの速さもサーバー間通信の速さも同じで、違うのはNVLinkでつながるGPUの数だ。
推論ではトークン1つごとにGPU間の通信を待つ
学習済みのAIモデルを使って回答を出す処理を「推論」という。AIは文章を「トークン」と呼ぶ単位に区切って処理する。モデルの内部は、同じ種類の計算をする「層」を何十も重ねた構造になっている。大規模なモデルは1基のGPUのメモリーに収まらないため、複数のGPUに分けて計算する。
1つの層の計算を複数のGPUで分担すると、層ごとに各GPUの計算結果を足し合わせ、全GPUに配り直す必要がある。エヌビディアの研究者らが2019年に発表した論文によると、このやりとりは1層あたり2回発生する。エヌビディアは2024年8月の公式ブログで、やりとりが終わるまで次の層の計算に進めないと説明している。
層の中に「専門モデル」を多数並べ、トークンごとに一部だけを使う「MoE」と呼ぶ方式のモデルでは、別のやりとりも生じる。ディープシークのAIモデル「R1」は、61層のうち58層がこの方式を採る。各層の専門モデルは256個で、トークン1つにつき、このうち8個を使う。各層にはこのほかに、どのトークンでも必ず使う専門モデルが1個ある。パラメーター (変数) は全体で6,710億個あるが、1つのトークンの計算に使うのは370億個にとどまる。
専門モデルを複数のGPUに分けて配置すると、層ごとに、トークンのデータを担当のGPUへ送り、計算結果を元のGPUに回収する必要がある。すべてのGPUが互いにデータを送り合う。トークンを1つ生成するたびに、58層それぞれで送信と回収が1回ずつあり、合わせて116回の通信を待つことになる。
AIが回答の文章を作る段階では、トークンを1つずつ順に生成する。トークン1つ分の計算は短時間で終わる。投稿者は、計算がすぐに終わるため、計算と並行して通信を済ませることができず、通信の遅延がそのまま回答の遅れにつながると指摘する。
ディープシークは論文で、GPUを毎秒400ギガビットのインフィニバンドでつないだ場合の通信時間を試算した。1つの層で32トークン分のデータを送り、結果を回収するまでに、通信だけで計120.96マイクロ秒かかる。処理するデータを2組に分けて交互に進める前提では、1層あたり241.92マイクロ秒になる。トークン1つの生成には最短でも14.76ミリ秒かかり、1秒間に生成できるのは約67トークンにとどまるという。この試算は、専門モデルを使う層を実際の58層ではなく、61層すべてとしている。
同社は論文で、同じ試算をGB200 NVL72にも当てはめた。32トークン分の送信と回収にかかる通信時間は6.72マイクロ秒、トークン1つの生成は最短0.82ミリ秒 (1秒間に約1,200トークン) に縮む。通信時間の差は18倍で、NVLinkとサーバー間通信の速さの差 (一方向の値で18倍) と同じだ。同社は、NVL72の数値は理論上の計算で、実機では確かめていないと明記している。
ただ、投稿者の言うように、計算と並行して通信を済ませられないとまでは言い切れない。ディープシークは2025年2月、自社サービスで回答を生成する段階の仕組みを公表した。中国向けに性能を抑えたエヌビディアの半導体「H800」を8基ずつ搭載したサーバー18台 (計144基) を、1つの単位として動かしている。サーバーをまたぐ通信は、NVLinkではなくネットワークを通る。同社は処理を5段階に分け、一部のデータをやりとりしている間に、別のデータの計算を進めている。
同社は、モデルの構造上、多くの利用者からの依頼をまとめて処理する必要があるとも説明している。利用者1人あたりの回答を生成する速度を上げると、まとめて処理できる依頼が減る。計算と並行して通信を済ませにくくなり、通信の遅延が回答の遅れとして表れやすくなるとみられる。
実機の測定ではNVL72が最大4.39倍、差は回答を生成する速度で変わる
米調査会社セミアナリシスは2026年5月、R1の改訂版を動かして、GPU1基が1秒間に生成するトークン数を測った結果を公表した。比べたのは、GB200 NVL72と、B200を8基搭載したサーバーを複数台つないだ構成だ。両者の差は、利用者1人あたりの回答を生成する速度によって大きく変わった。
利用者1人あたり毎秒25トークンで回答を生成する条件では、NVL72の処理能力はB200の8基のサーバーの1.15倍にとどまった。毎秒100トークンでは2.23倍、125トークンでは4.39倍に広がった。毎秒125トークンの条件で、GPU1基が1秒間に生成したトークン数はNVL72が4,130、B200が941だった。毎秒200トークンでは1.30倍に縮み、250トークンではB200がわずかに上回った (0.97倍)。
この測定では、NVL72で専門モデルを32基のGPUに分けて配置した。B200の8基のサーバーでは、9基以上に広げると通信がサーバーの外のイーサネットを通るため、8基の中に収めた。
専門モデルを64基に分散配置、NVL72ならラック1台に収まる
エヌビディアは2025年6月の公式ブログで、R1ではGPU1基に専門モデルを4個程度配置するのが一般的で、256個を収めるには64基が必要になると説明した。この64基をNVLinkでつながる範囲に収める必要があり、サーバーをまたぐとインフィニバンドでの通信がボトルネックになるとしている。同じブログにある性能の数値は、実機で測ったものではなく、同社がシミュレーションで算出した。
同社は2025年10月にも公式ブログで、GB200 NVL72の中で専門モデルを64基のGPUに分けて配置する例を挙げた。64基は、72基を載せたラック1台に収まる。同じブログには、実機で測った結果も載っている。利用者1人あたり毎秒100トークンの条件で、専門モデルを32基に分けて配置すると、GPU1基あたりの処理能力は8基の場合の最大1.8倍になった。
推論用ソフトウエアを紹介する同社の公式ブログには、GB200 NVL72の中で専門モデルを16基、32基に分けて配置した例もある。専門モデルごとの負荷を平準化する仕組みや、入力された文章の処理と回答の生成を別々のGPUで担う方式などを組み合わせた。GPU1基あたりの処理能力は、4基、8基に分けた場合に比べ最大6.17倍に高まった。
GPU8基のサーバーで専門モデルを64基に分けて配置すると、サーバーは8台にまたがる。専門モデルが8台に均等に配置されていれば、1つのトークンが使う専門モデルのうち平均8分の7は、ほかの7台にあることになる。投稿者は、サーバーをまたいでも動作はするが、通信の大半がサーバー間通信になると指摘する。
ディープシークは「V3」と呼ぶモデルの学習で、H800を8基ずつ搭載したサーバーを使い、専門モデルをサーバー8台の計64基に分けて配置した。サーバー内はNVLink、サーバー間はインフィニバンドでつないだ。H800は、NVLinkのデータ転送速度も抑えた製品だ。同社の技術報告書によると、データ転送速度はNVLinkが毎秒160ギガバイト、インフィニバンドが毎秒50ギガバイトで、約3.2倍の差がある。このため同社は、1つのトークンの送り先を8台のうち最大4台に絞り、サーバー間の通信を減らした。
NVL72の導入を確認できたのはソフトバンクとKDDI
GPUの計算基盤を自社で使ったり、外部に貸し出したりしている日本の9社・グループの開示資料を調べた。対象はソフトバンク、KDDI、さくらインターネット、GMOインターネット、データセクション、NTTドコモビジネス、富士通、NEC、日立製作所だ。各社の発表でGB200 NVL72の導入を確認できたのは2社だった。
ソフトバンク (9434) は2025年12月25日、GB200 NVL72を使った計算基盤を22日に稼働させたと発表した。GPUは1,224基で、1台72基のラックに換算すると17台分にあたる。将来は4,000基超に増やす計画だが、時期は示していない。これとは別に、2025年7月にはDGX B200 (1台8基) を使った4,000基超の計算基盤も整備した。2026年3月には、GPUサーバーの貸し出しサービスで、GB200を使うサーバーの提供をベータ版 (試用版) として始めた。GPU4基を搭載した装置1台から、1社だけで使える。料金は月額456万9,000円 (税抜き) からとしている。
KDDI (9433) は2026年1月22日、大阪府堺市のデータセンターでGB200 NVL72を稼働させた。米ヒューレット・パッカード・エンタープライズ (HPE) と組み、HPEの装置を導入した。GPUの数は開示していない。「KDDI GPU Cloud」では、NVL72に載る装置を1台から借りられる。両社とも小さな単位から貸し出しており、72基をまとめて使うかどうかは、利用者がどれだけ借りるかで決まる。
表2 日本企業のGPUの機種と、NVLinkでつながるGPUの数
| 会社 | 証券コード | 機種 | GPUの数 | NVLinkでつながるGPU |
|---|---|---|---|---|
| ソフトバンク | 9434 | GB200 NVL72 | 1,224基 | 72基 |
| ソフトバンク | 9434 | DGX B200 | 4,000基超 | 8基 |
| KDDI | 9433 | GB200 NVL72 | 開示なし | 72基 |
| さくらインターネット | 3778 | H100・H200・B200 | 約5,400基 | 8基 |
| さくらインターネット | 3778 | HGX Rubin NVL8 (計画) | 開示なし | 8基 |
| GMOインターネット | 4784 | H200・HGX B300 | 968基 | 8基 |
| データセクション | 3905 | B300 | 5,080基 | 8基 |
| 日立製作所 | 6501 | HGX B200など | 開示なし | 8基 |
出所: 各社のプレスリリース・決算説明資料・適時開示、日立製作所は日本経済新聞の報道。さくらインターネットの約5,400基とGMOインターネットの968基は機種ごとの数の合計 (本稿の計算)。GMOインターネットの968基は稼働中の分で、B300の追加分を含めると計1,816基になる (同)。データセクションの1台8基は、GPUの数を台数で割った本稿の計算。
さくらインターネット (3778) の2026年7月の決算説明資料によると、生成AI向けにH100を2,840基、H200を1,072基、B200を約1,500基設置した。サーバーはいずれも1台に8基を搭載する。同社は同じ日、次世代GPUを搭載した「NVIDIA HGX Rubin NVL8」のラックなどに260億円を投じると開示した。納入は2027年1月の予定だ。エヌビディアの製品ページによると、HGX Rubin NVL8はGPUを8基搭載する。さくらインターネットはNVL72の導入計画を開示していない。同社のGPU事業の採算はGPUの1時間あたりの売上を検証した記事で取り上げた。
GMOインターネット (4784) の2026年8月の決算説明資料によると、H200を搭載したサーバー96台 (768基) と、HGX B300を搭載したサーバー25台 (200基) が稼働している。B300はさらに、2回に分けて42台と64台を追加することを決めている。稼働中の25台と合わせると131台で、1台8基で計算すると1,048基になる。追加分は、42台が2026年10〜12月、64台が2027年4〜6月に提供を始める予定だ。データセクション (3905) は2026年5月、千葉県印西市にB300を5,080基 (サーバー635台) 導入すると開示した。7月17日には納入が始まったと発表した。
日本経済新聞は2025年9月、日立製作所が「HGX B200」などのGPUサーバーを日米欧で導入したと報じた。日立は導入の規模を明らかにしていない。調査対象の企業ではないが、産業技術総合研究所のAI向け計算基盤「ABCI 3.0」も、H200を8基ずつ搭載したサーバー766台 (計6,128基) をインフィニバンドでつないでいる。調べた9社・グループで、GB300 NVL72の導入を発表した会社は見当たらなかった。
さくらインターネットの次世代GPUは提供時期が未定、NTTドコモビジネスは構成を公表せず
NTTドコモビジネスは2026年9月30日、GPUを1基単位で貸し出すサービスを始めた。発表資料には、GPUの機種も、1台8基のサーバーかNVL72かも記していない。さくらインターネットは、次世代GPUの導入数とサービスの開始時期を未定としている。AIを動かすGPUなどの種類は、当サイトのAI計算資源の解説 (計算機)にまとめている。
投資家向けの個別銘柄の調査と、技術面の資産査定 (デューデリジェンス) のご相談は、編集部のお問い合わせ窓口までお寄せください。








💬 この記事へのコメント 0
まだコメントはありません
最初のコメントを投稿してみましょう!⚠️ エラーが発生しました