AIデータセンターの投資競争は、半導体から受電容量とチップ直接液冷システムの確保へ主戦場が移った。NVIDIAの最新設備が1ラック120kWを消費するなか、電力網と冷却部材の供給網が産業の勝敗を決める。
ソフトウェアや生成AIはデジタル空間の産物に見えるが、その実態は膨大な電力と冷却水を消費する重厚長大インフラである。最先端の半導体製造工場(ファブ)の建設に1拠点あたり約200億ドルを要するのと同様に、それらの半導体を数万基単位で並列稼働させるデータセンターもまた、変圧器、銅母線、冷凍機、光ファイバーの塊にほかならない。
米国の調査機関Epoch AIが2010年から2024年までに発表された主要333モデルの学習計算量を集計したデータによれば、AIモデルの学習に要する浮動小数点演算(FLOP、小数点を含む数値の四則演算回数)は年率4.1倍〜7倍のペースで拡大してきた。2012年に登場したAlexNetの学習計算量は約10の18乗FLOPであったが、AlphaGo MasterやAlphaGo Zeroを経て、2020年のGPT-3で約3×10の23乗FLOP、PaLMを経て2023年のOpenAIによるGPT-4では推定210億ペタFLOP(2.1×10の25乗FLOP、1ペタFLOPは10の15乗回)、GoogleのGemini Ultraでは約5×10の25乗FLOPに達した。
この210億ペタFLOPという演算量は、毎秒約11兆回(0.01ペタFLOP)の演算能力を持つiPhone 12で処理すれば完了に6万年以上を要し、1997年製の100MHz Pentiumプロセッサ(毎秒920万FLOP)では理論上660億年以上かかる規模である。この計算を数カ月で処理し、さらに学習後の推論(インファレンス)を24時間体制で世界中に提供するため、ハイパースケーラー(巨大クラウド事業者)は設備投資の規模を異次元の水準へと引き上げている。
1GWあたり160億ドルを要する投資構造と米ハイパースケーラーの財務検算
現在、データセンターの規模を測る基準は床面積やラック数ではなく「受電容量(メガワット=MW、またはギガワット=GW)」に完全に一本化されている。どれだけ広大な建屋を用意しても、引き込める電力の上限がそのまま稼働できるGPU(画像処理半導体)の数を規定するためだ。
AmazonはAI需要の増加を見越して今後15年間でデータセンターに1,500億ドルを投じる計画を打ち出し、Metaは2024年単年でAIインフラとデータセンターを中心に370億ドルを支出した。さらに米国証券取引委員会(SEC)に提出された2025年から2026年にかけての決算書類を精査すると、Alphabet(Google)、Microsoft、Amazon、Metaの北米4社にOracleなどを加えた主要クラウド事業者のAIインフラ・データセンター関連設備投資(CapEx)は、2025年の米国市場全体で約4,500億ドル、2026年には世界のビッグテック合計で年間6,000億ドル(約90兆〜100兆円)に迫る規模へと膨張している。
なぜこれほど巨額の資金が消えるのか。ここで1つ目の検算として、受電容量1GW(1,000MW=大型原子力発電所1基分の出力に相当)のデータセンターを構築する際の資本支出(CapEx)の分解検算を行う。
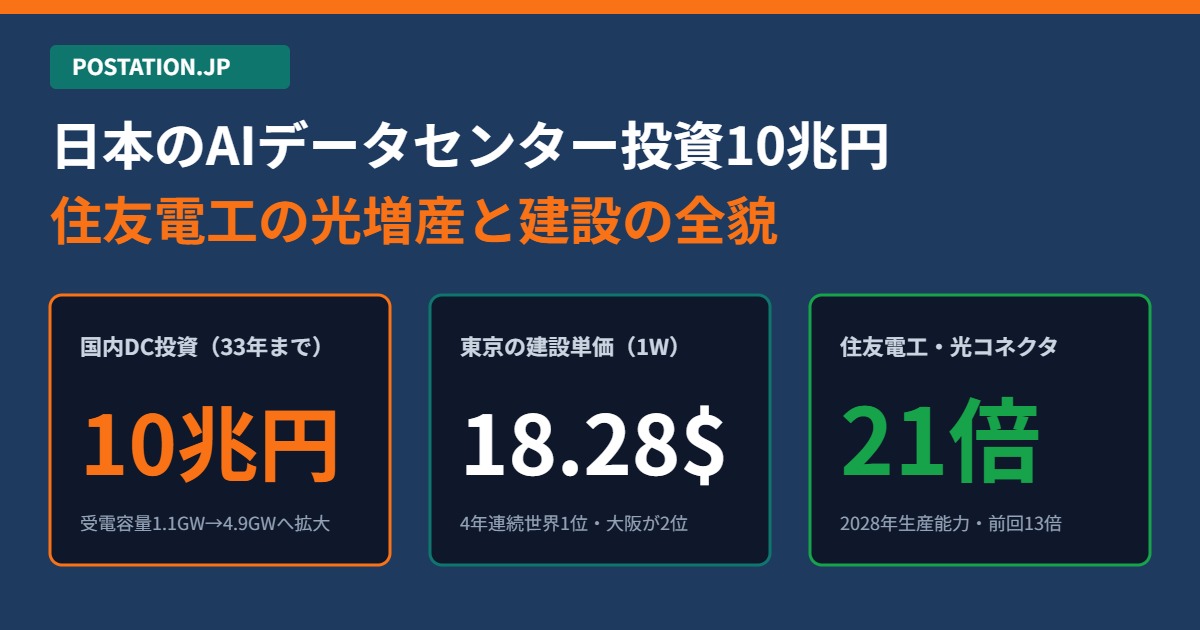
日本経済新聞が2026年9月に国内データセンター事業者26社を対象に実施した調査では、26社中22社がAI向け拠点の拡張を計画しており、日本のデータセンター受電容量は2025年末の1.1GWから2033年には4.9GWへと約4.5倍(3.8GW増=大型原発約4基分)に拡大する見通しが示された。この3.8GWの増設に投じられる総投資額は8年間で約10兆円を超えると試算されている。10兆円を3.8GWで割ると、1GWあたりの投資額は約2兆6,300億円(1ドル=155円換算で約169億ドル、約160億〜170億ドル/GW)となる。これは土地取得、高耐荷重の建屋、特別高圧の受変電設備、非常用ガスタービン・ディーゼル発電機、そして液冷・空調設備といった「箱とインフラ(シェル&コア)」を中心とした数字である。
ここにハイパースケーラーが自ら調達して搬入するAIサーバー群(NVIDIAのGB200 NVL72など)のコストを加算する。1ラックあたり120kWを消費するGB200 NVL72のシステム単価は約300万ドル(約4.6億円)である。受電容量1GWの施設でPUE(電力使用効率)を1.15と仮定すると、IT機器に使える電力は約870MWとなり、120kWのラックを約7,250本稼働できる。7,250本×300万ドル=約217億5,000万ドル(約3.3兆円)、さらにラック間を繋ぐ光トランシーバーやネットワークスイッチ群(サーバー費用の約15〜20%)を加えると、IT機器だけで1GWあたり約250億〜260億ドルを要する。
すなわち、土地・建屋・電源・冷却設備(約160億ドル/GW)とAI半導体・通信機器(約250億ドル/GW)を合わせた「フルスタックのAIデータセンター構築コスト」は、1GWあたり総額400億〜420億ドル(約6.2兆〜6.5兆円)に達する。調査会社SemiAnalysisが集計した主要ハイパースケーラーの容量データを見ると、米国勢5社は2022年時点の既存容量に対して将来計画容量が、Googleで既存3,024MWに対し追加計画2,905MW、Microsoftで既存2,176MWに対し計画3,344MW、Amazonで既存2,480MWに対し計画2,533MW、Metaで既存1,790MWに対し計画2,595MW、Appleで既存600MWに対し計画1,403MWと、5社合計で12,780MW(12.78GW)の追加パイプラインを抱えている。この12.78GWをフルスタック単価(約400億ドル/GW)で掛け合わせると約5,112億ドルとなり、米ビッグテック各社が2024年から2026年にかけて投じている数千億ドル規模のキャッシュフロー流出額とピタリと符合する。
一方、同調査における中国勢の容量は、Alibabaが既存1,350MWに対し追加計画487MW、Baiduが既存608MWに対し計画約30MW、Huaweiが既存494MWに対し計画約150MW、Tencentが既存487MWに対し計画約120MWと、米国勢の10分の1以下の拡張ペースにとどまっている。米政府による最先端AI半導体と製造装置の対中輸出規制が、そのままデータセンター設備容量の差となって表れていることが分かる。また新興勢力では、AI特化クラウドの米CoreWeaveが2024年に28カ所のデータセンター建設を進め、導入したNVIDIA製GPU自体を担保に差し出すスキームで100億ドル超の資金を調達し、巨額の先行投資を回している。
100MWを熱に変える物理構造とTier IVの冗長設計、PUE 1.1の限界点
そもそもデータセンターとは、電力網から受け取った電気エネルギーを100%「熱」に変換する施設である。
1964年にIBMがメインフレーム「System/360」を発売した際、同社は顧客に200ページの物理計画マニュアルを渡し、空間・電力要件、温度範囲、空気ろ過の基準を定めた。しかし長らく、電算室はオフィスや大学、倉庫の一角に置かれるのが一般的であった。米国エネルギー情報局(EIA)によると、2012年時点で米国内の97,000棟の建物内にデータセンターが存在したが、平均面積は約2,000平方フィート(約186平方メートル)で、入居する建物の床面積の平均2%を占めるに過ぎなかった。Googleの最初の拠点も、AltaVista、eBay、Inktomiと共用する施設内の28平方フィート(約2.6平方メートル)のケージに収めた30台のサーバーであった。それが現在、Googleは世界37カ所の専用データセンター(一部は約100万平方フィート=約9.3万平方メートル規模)で数百万台のサーバーを運用している。
『The Datacenter as a Computer』に示された現代の大規模データセンターの全体構造は、大きく「電力系統」と「冷却系統」の2つで構成される。外部の商用送電網(Utility Power)から引き込まれた特別高圧電力は、まず屋外の大型変圧器(Transformers)で降圧され、非常用発電機および配電盤(Backup Generation / Power Distribution)を経て、建屋内の太い銅母線(Power Bus)を通じて各サーバーラック(Rack)へ供給される。ラックの高さは「U(ユニット、1U=1.75インチ=約44.45ミリメートル)」で規格化されており、標準的な42Uまたは48Uのラックに数十台のサーバー(Server)や通信スイッチが垂直に格納され、別室のネットワーキングルーム(Networking Room)から外部の通信網へと接続される。
ラックマウント型サーバー1台の消費電力は数百ワット(家庭用ヘアドライヤーの約5分の1)だが、数万台が集まると1拠点で100MW(1億ワット)から最大750MW超を消費する。100MWの電力は一般家庭約75,000世帯分に相当する。また製鉄所の電気アーク炉は鉄1トンを溶かすのに650kWhを要し、毎時130〜180トン(平均150トン)を生産する標準的な電気炉の消費電力が97,500kW(97.5MW)であるため、100MWのデータセンターは製鉄所の電気炉1基を24時間連続稼働させるのと同じ電力を消費し続ける計算になる。
さらにデータセンターは、1分間の停止で数万ドル以上の損失を生むため、Uptime Instituteの基準(および『The Data Center Builder's Bible』の設計要件)に基づくTier I〜IVの厳格な信頼性設計が求められる(一部事業者は非公認のTier Vを主張している)。
| 設計・立地要件 | Tier I / II(基本・単一経路) | Tier III(無停止保守対応) | Tier IV(完全二重化・稼働率99.995%) |
|---|---|---|---|
| 洪水リスクと水路距離 | 洪水区域外 / 水路規定なし | 100年洪水区域外 / 水路100ヤード超 | 100年洪水区域から100ヤード超 / 水路0.5マイル超 |
| 空港・都市圏からの距離 | 規定なし / 規定なし | 空港1〜30マイル / 都市圏30マイル未満 | 空港5〜30マイル / 都市圏10マイル未満 |
| 冗長ルーター・耐火時間 | なし / 建築基準法規通り | あり(Yes) / 1時間耐火 | あり(Yes) / 2〜4時間耐火 |
| 床耐荷重・発電機容量 | 150〜175 psf / IT・通信系のみ | 250 psf / IT・通信系+予備1基 | 250 psf(約1.22t/平米) / 建物全体+予備1基 |
| 燃料備蓄・給電経路 | 8〜24時間 / 1系統 | 72時間 / 稼働1+待機1系統 | 96時間 / 稼働2系統(2アクティブ) |
| UPS(無停電電源)・冷却冗長性 | NまたはN+1 / なしまたは予備1基 | N+1 / 1電源喪失時も冷却維持 | 2N / 1電源喪失時も冷却を完全維持 |
米国の主要施設はこのTier III〜IVで建てられており、床耐荷重250 psf(1平方フィートあたり250ポンド=1平方メートルあたり約1.22トン)の強固な床の上にラックが並ぶ。そして過去15年間、データセンター業界はこの施設全体の消費電力をIT機器の消費電力で割った「PUE(電力使用効率)」を下げることで電力危機を回避してきた。
Uptime Instituteの調査(567件の回答平均)によると、2007年に2.50(IT機器1Wに対し空調や電源ロスに1.5Wを消費)だった大規模データセンターの平均PUEは、2011年に約1.98、2014年に1.65へと急低下した。ホットアイル(暖気通路)とコールドアイル(冷気通路)を分離する気流管理や、AC/DC(交流・直流)電源変換効率の改善(旧世代の60〜70%から最新部品では最大95%へ向上)、待機電力の削減、そして1970年から2020年まで約1.5年ごとに計算あたりのエネルギー効率を倍増させてきたムーアの法則が相乗効果を生んだためである。
ローレンス・バークレー国立研究所(LBL)の統計では、米国のデータセンター電力消費量は2000年の年間約290億kWhから2007年に約670億kWhへ倍増した後、2014年の約700億kWhまで横ばいとなった。2010年時点の効率(2010 Energy Efficiency)のままなら2020年に約1,950億kWhへ達していたはずが、ハイパースケーラーへの移行(Hyperscale Shift)や運用改善(Improved Management)、最良慣行(Best Practices)の組み合わせ(IM+HSやBP+HS)により、実際には400億〜730億kWhの範囲に封じ込められた。国際エネルギー機関(IEA)のデータでも、2015年から2022年にかけて世界のインターネット利用者が30億人から53億人(78%増)、通信量が0.6ZBから4.4ZB(600%増)、データセンターのワークロードが1億8,000万から8億(340%増)へ拡大したのに対し、電力使用量は200TWhから240〜340TWh(20〜70%増)にとどまっていた。
しかし、Uptime Instituteの平均PUEグラフを精査すると、2014年の1.65以降、2018年に1.58、2019年に1.67、2020年に1.59、2022年に1.55、2023年1月1日時点で1.58と、約10年間にわたり改善が完全に止まっている。Meta(平均PUE 1.09)やGoogle(同1.10)では非IT電力の割合がすでに1割を切り、施設側の省エネ余地が物理的な限界(漸近線)に到達した瞬間に、年率4〜7倍で計算量が膨張する生成AIの波が直撃したのである。
空気冷却の物理的崩壊とチップ直接液冷(DLC)の熱力学・投資回収期間
なぜ既存の空冷データセンターにAIサーバーをそのまま置くことができないのか。熱力学と流体力学の数値で検証すると、その物理的限界が明確になる。
従来のデータセンターは、3つの熱交換ループ(3ループ冷却系統)と床下送風(42U.com等の標準断面構造)で熱を逃がしてきた。第1のループ(データセンターフロア)では、電算室用空調機(CRAC)やファンコイル熱交換器(Fan Coil Air Handling Units / Heat Exchangers)が二重床の下からコールドアイル(Cold Aisle)へ冷気(Supply Air)を送り、サーバー内部を通過して高温になった排気(Return Air)を背面のホットアイル(Hot Aisle)から天井裏(圧力バランス用のLoose Seal Barrierを備えた空間)へ回収する。第2のループ(プロセスループ)では、ファンコイルで空気の熱を冷水(Process Water)に移し、冷凍機の蒸発器(Chiller Evaporator、水から冷媒への熱交換器)で冷却する。第3のループ(コンデンサーループ)では、冷凍機の凝縮器(Chiller Condenser、冷媒から水への熱交換器)と冷却プラント熱交換器(Cooling Plant Heat Exchangers)から屋外の蒸発式冷却塔(Evaporative Cooling Towers)や貯水槽(Water Storage、夜間電力で冷水を蓄える100万ガロンのコールドバッテリーを含む)へと熱を運び、大気中へ放散する。
この空冷方式の致命的な弱点は、空気の「体積熱容量(単位体積あたりの熱を運ぶ能力)」の低さにある。乾燥空気の定圧比熱は約1.006 kJ/(kg・K)、密度は約1.2 kg/m3であり、体積熱容量はわずか約1.2 kJ/(m3・K)に過ぎない。サーバーの吸気と排気の温度差(ΔT)を約15℃と設定した場合、1kWの熱を除去するには毎分約120立方フィート(CFM、約3.4 m3/分)の風量が必要となる。100MWのデータセンター全体では、毎分1,200万立方フィート(約34万立方メートル)という巨大な空気の塊をファンで押し出し続けなければならない。
2000年代初頭に1ラックあたり約1kWだった電力密度は、一般的な企業向けで5〜10kW、従来のハイパースケーラーで15〜20kWへと上昇してきた。しかし、NVIDIAのH100を32基搭載するSuperPODでは1ラックあたり40kWを超え、B200(Blackwell)を72基搭載する「GB200 NVL72」では1ラックあたり120kW〜140kW、さらに2026年以降の次世代AIラックでは平均370kWに達する見通しとなっている。
ここで2つ目の検算として、120kWのラックを空冷で処理しようとした場合の物理的破綻を計算する。1kWあたり120 CFMの法則を当てはめると、120kWのラック1本に毎分14,400 CFM(毎秒約6.8立方メートル)の風を送り込む必要がある。標準的な42Uラックの前面開口面積を約1.2 m2(有効開口率60%で約0.72 m2)とすると、ラック前面を通過する空気の風速は 6.8 ÷ 0.72 = 秒速9.4メートル(時速約34キロメートル)という強風になり、送風ファンの消費電力(風量の3乗に比例して増大)が爆発してブレーカーが落ち、騒音と風圧で保守作業すら不可能になる。実際の空冷の物理的上限は1ラック20〜30kW、ラック背面に水冷コイルを取り付けるリアドア熱交換器(RDHx)を併用しても50kWが限界である。もし120kWの機材を空冷施設に置くなら、風道を確保するためにラックを極端に間引くしかなく、IT機器の占有床面積がデータセンター全体の10%まで落ち込む。しかも、GB200 NVL72は72基のGPUを高速銅線(NVLink)で超短距離接続することで初めて性能が出るため、別々のラックに分散配置することはアーキテクチャ上許されない。
これに対し、水(またはプロピレングリコール水溶液)の比熱は約4.18 kJ/(kg・K)、密度は約1,000 kg/m3であり、体積熱容量は約4,180 kJ/(m3・K)と空気の約3,500倍、熱伝導率は約25倍に達する。この圧倒的な熱輸送能力を利用するのが、GoogleのTPUやNVIDIAのGB200 NVL72が標準採用した「チップ直接液冷(Direct-to-Chip Liquid Cooling:DLC)」である。
DLC方式では、発熱量の75〜85%を占めるGPUとCPUの直上に、内部に幅0.1〜0.2ミリメートル単位の微細な銅製フィン(マイクロチャネル)を刻んだ「コールドプレート(受熱板)」を密着させる。1ラック120kWの熱を、冷却液の温度上昇(ΔT)10℃で回収する場合、必要な流量は毎分約172リットル(1kWあたり毎分約1.4〜1.5リットル)に過ぎず、直径数センチメートルの配管で容易に処理できる。
経済性の転換点(ティッピングポイント)も明確に出ている。調査機関Grand View ResearchおよびENKIの2026年市場分析によれば、1ラックあたり50〜60kWを超えると、空冷の巨大な空調機と送風電力の運用コスト(OpEx)が跳ね上がるため、初期設備投資(CapEx)が高い液冷システムを導入しても3年未満の投資回収期間(ペイバック・ピリオド)で元が取れる。実際、AIデータセンターにおける液冷の導入比率は2024年の14%から2025年に33%へ急伸し、2026年には40%超(新設のAI専用拠点ではほぼ100%)に達している。Metaが建設中だった複数の空冷データセンター計画を中止して液冷仕様へ全面再設計したのは、この熱力学と投資回収の計算に基づいている。
送電網の接続渋滞とAmazon・Talen原発直結契約が米FERCに却下された理由
液冷技術によってラック内部の熱壁は突破できたとしても、そもそも敷地まで電気を運ぶ「送電網(グリッド)」の壁はさらに険しい。
現在、世界のデータセンター消費電力(2022年時点で世界全体の1〜1.3%=約240〜340TWh、暗号資産マイニングを含め約460TWh)は、IEAおよびSemiAnalysisの推計で2026年に620〜1,050TWh(日本の年間総消費電力量である約909TWhに匹敵する規模)へと急増し、2030年には世界の全電力の3〜4.5%(米国国内では全電力の最大9%)に達する見通しである。しかもデータセンターは特定の地域に極端に集中する。アイルランドでは国内電力の約18%をデータセンターが消費し、2028年には30%に達するため、ダブリン周辺での新設が2028年まで凍結(モラトリアム)された。シンガポールも2019年から2022年まで新設を停止した。世界最大の集積地である米バージニア州では、Virginia Powerの販売電力の24%がデータセンターに吸い取られ、北バージニアの郡当局が電力不足を理由に史上初めて建設申請を却下する事態となった。
CBREの統計(2023年時点の北米建設中容量3,077.8MW)を見ても、北バージニア(既存在庫2,499MWに対し建設中1,237MW)の飽和を受け、電力に余力のあるジョージア州アトランタ(既存310MWに対し建設中733MWと2.3倍に急増)、テキサス州ダラス・フォートワース(既存565MW / 建設中287MW)、オレゴン州ヒルズボロ(既存262MW / 建設中281MW)、イリノイ州シカゴ(既存560MW / 建設中約120MW)、シリコンバレー(既存428MW / 建設中約110MW)、アリゾナ州フェニックス(既存360MW / 建設中約160MW)、ニューヨーク周辺3州(既存約180MW / 建設中約120MW)へと建設地が分散している。
米国でも日本でも、最大の障壁は「発電所が足りないこと」以上に「送電線と変電所の接続待ち(インターコネクション・キュー)」にある。「データセンターは1〜2年で建つが、電力インフラの増強には3年以上かかるか見通せない」ため、MetaのMark Zuckerberg CEOも「エネルギーさえ手に入れば、今よりさらに大きなクラスターを建てている」と認めている。一方、電力会社から見れば、24時間一定の大電力を消費し続け(負荷平準化の余地がなく)、かつ将来の需要変動リスクがあるデータセンターのために、耐用年数40年の送電網を先行投資するのはリスクが高い。そのためオハイオ州の電力会社(AEP Ohio)は要求電力の90%の買い取り義務を提案し、北バージニアに給電するDuke Energyも最低電力購入義務(ミニマムテイク要件)を課した。
この送電網の渋滞をバイパスする奇策として2024年3月に実行されたのが、Amazon Web Services(AWS)による米Talen Energy傘下の「Cumulusデータセンターキャンパス」買収(総額6億5,000万ドル)であった。ペンシルベニア州のサスケハナ原子力発電所(出力2.5GW)の敷地隣にある既存48MWの施設を買い取り、送電網を通さずに原発から直接電力を引き込む「ビハインド・ザ・メーター(計器の裏側)給電」によって、最大960MWまで拡張する計画であった。
しかし、一次資料である米連邦エネルギー規制委員会(FERC)の審理記録(Docket No. ER24-2172)を追うと、この構想が制度の壁に阻まれた理由が分かる。サスケハナ原発が属する広域送電機関PJMは、AWS向けの直結給電枠を既存の300MWから480MW(最終的に960MW)へ引き上げる修正相互接続サービス契約(ISA)をFERCに申請した。これに対し、送電網を運営する公益電力会社のAEPとExelonが猛烈な反対意見書を提出した。両社の主張の核心は「Amazonが送電網の維持管理コスト(託送料金)を負担せずに原発の安定電力を横取りすれば、公衆送電網の供給予備力が削られ、残された一般家庭や工場の電気料金が年間数億ドル単位で跳ね上がる」という点にあった。2024年11月、FERCはこの公益上の懸念を認め、2対1の評決で拡張申請を却下した。米国におけるAIデータセンターの拡張は、単なる企業の用地取得を超え、国の電力市場の公平性と安全保障を巡る制度設計の闘争へと突入している。
住友電工の光コネクタ13倍増産と日立・ニデックが握る供給網の収益構造
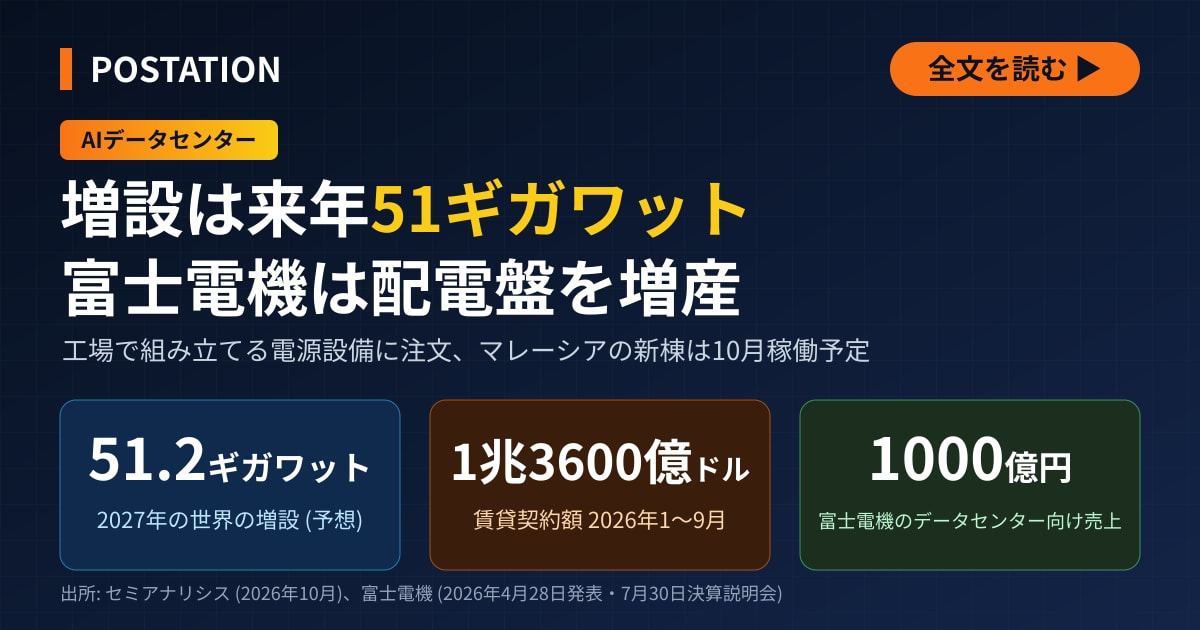
この米国の年6,000億ドル、日本の8年間10兆円(受電容量1.1GW→4.9GW)というAIデータセンター投資の奔流において、最も確実なキャッシュフローを回収しているのは誰か。それはAIモデルを開発するソフトウェア企業ではなく、データセンターの物理的ボトルネックである「光配線」「超高圧送電・変圧器」「液冷モジュール」を寡占する日本の部材・重電メーカー群である。各社の直近決算(2026年3月期実績および2027年3月期業績予想・中期経営計画)の数字から、その収益構造を解剖する。
1. 住友電気工業とフジクラ:GPU間を結ぶ超高密度光配線と直流送電網の二刀流
生成AIの学習では、数万基のGPUを1つの巨大コンピュータとして同期させるため、ラック間を無数の光ファイバーで結ぶ必要がある。従来の通信ケーブルでは帯域と配線スペースが限界に達し、1本のケーブルに数千〜1万本以上の光ファイバーを高密度実装した「超高多心光ケーブル」と「多心光コネクタ」、そして電気信号と光信号を変換する化合物半導体基板「リン化インジウム(InP)」の需要が爆発している。
住友電気工業の2026年3月期決算および中期経営計画(2029年3月期目標)の開示資料を精査すると、データセンター特需が同社の利益構造を劇的に変えている事実が浮かび上がる。同社の情報通信セグメントの営業利益は、2026年3月期に774億円へと急拡大し、2029年3月期には全社営業利益目標6,000億円の実に40%にあたる「2,400億円」を単独で稼ぎ出す計画となっている(2027年3月期通期の全社業績予想も売上高5兆7,500億円、営業利益5,000億円へと上方修正された)。
同社は総額1兆円の設備投資(および5,400億円の研究開発費)を投じ、2024年度を「1」とした場合のデータセンター向け戦略4製品の生産能力を以下の倍率で引き上げている。
| 住友電気工業の戦略製品 | 2024年度基準 | 2026年度 生産能力倍率 | 2028年度 生産能力倍率 | 技術的役割と供給網での位置づけ |
|---|---|---|---|---|
| 光コネクタ(多心・高密度) | 1.0倍 | 6.0倍 | 13.0倍 | ラック間の超高密度光配線の接続急所、高採算の収益柱 |
| データセンター内光デバイス | 1.0倍 | 2.0倍 | 4.0倍 | 800G/1.6T光トランシーバー向け受発光素子、CPO対応 |
| InP(リン化インジウム)基板 | 1.0倍 | 1.8倍 | 3.0倍 | 高速レーザー光源の必須基板(面積換算、世界トップ級シェア) |
| 光ファイバー(超低損失・細径) | 1.0倍 | 1.3倍 | 2.0倍 | データセンター内部および拠点間(DCI)・海底ケーブル用 |
4年間で光コネクタの生産能力を13倍に引き上げるという決断は、北米ハイパースケーラーからの長期受注の裏づけがあって初めて可能な数字である。また競合のフジクラも、2025年7月に世界最多心数となる「13,824心(1本で約1万4,000チャンネルの通信が可能)」の超高密度光ケーブルの販売を開始し、北米データセンター向けの営業利益率が急伸している。
さらに住友電工の強みは、通信(光)だけでなく「電力(送電線)」のボトルネックも同時に押さえている点にある。ギガワット級のデータセンターへ長距離送電するには、交流よりも送電ロスが少ない超高圧直流(HVDC)ケーブルが不可欠となる。同社はドイツの送電事業者Amprionから、世界初の525キロボルト直流XLPE(架橋ポリエチレン)絶縁ケーブルを採用した「A-Nord」や「Korridor B V49」など計3案件・総額5,500億円超の大型受注を獲得しているほか、2026年2月には1,333億円を投じて住友電設を完全子会社化(持株比率49.64%からTOB等で100%化)し、データセンターの電力・通信工事を一括で請け負う体制を完成させた。
2. Vertiv・Schneider Electricと日本勢(ニデック・重電・化学)の液冷・変圧器争奪戦
一方、1ラック120kWの熱を処理する液冷システム市場(Grand View Research推計で2025年の約67億ドルから2033年に295億ドル、AI特化領域では年率28.7%成長で618億ドル規模へ拡大)では、欧米のインフラ大手と日本の精密・化学メーカーの間で合従連衡が進んでいる。
Global Market Insightsの2025〜2026年市場シェア調査によると、AIデータセンター向け液冷市場では仏Schneider Electric(Motivairを買収しシェア9.0%超で首位)、米Vertiv Holdings、独Rittal、独STULZ、米Boyd Corporationの上位5社が世界シェアの35.0%を握っている。ここにサーバーOEMの米Super Micro Computer(Supermicro)やDell Technologies、台湾のDelta Electronics(台達電子)、奇鋐科技(AVC)が加わり、ラック単位でCDU(冷却液分配装置)とマニホールドを事前検証(プリバリデーション)して納入する標準化競争が起きている。
この液冷サプライチェーンの中で、ニデック(旧日本電産)はSupermicro等と連携し、CDUの心臓部である高効率・無漏洩ポンプ、コールドプレート、クイックディスコネクト(迅速継手)の垂直統合生産を拡大している。CDUは1台でもポンプが止まれば120kWのラックが数分で焼損するため、冗長ポンプと精密な流量制御バルブの信頼性が参入障壁となり、高い利益率を生む。
また、将来的な1ラック200kW〜370kW時代に向けた「液浸冷却(サーバーを絶縁液に沈める方式)」では、化学規制が供給網を揺さぶっている。欧州や米国でPFAS(有機フッ素化合物)規制が強化され、米3Mが2025年末までにフッ素系不活性液体(フロリナート等)の生産から撤退したことで、非PFAS系の絶縁冷却液(合成炭化水素油や次世代エステル系冷媒)の開発が急務となった。この領域では、ENEOSホールディングスや出光興産、AGC、ダイキン工業が次世代冷却液と大型チラー(冷凍機)の両面でハイパースケーラーとの共同検証を進めている。
そして、送電網からデータセンターの入り口までの受変電設備では、世界的な変圧器(トランス)と開閉装置の枯渇を背景に、日立製作所(日立エナジー)が圧倒的な価格決定権を握っている。AIデータセンターは負荷変動が激しく、高調波ノイズに耐える特殊設計の大型変圧器を要するため、北米や欧州での納期は3〜4年に延びている。日立エナジーの受注残高は5兆円規模に達し、三菱電機、富士電機、ダイヘンとともに、ハイパースケーラーの設備投資を最も川上で吸収する構造を築いている。
さらにその先には、現在の「ラックあたり120kW」という消費電力そのものを根底から引き下げる技術として、電気配線を光配線に置き換える「光電融合(Co-Packaged Optics:CPO)」と次世代半導体パッケージの実装が控えている。NVIDIAが宣伝する「GB200の推論効率25〜30倍」は、あくまで「ワットあたりの生成トークン数(Tokens per Watt)」の理論値であり、施設全体の絶対的な消費電力が減るわけではない。真に電力消費を抑えるには、スイッチチップやGPUパッケージの内部に光素子を直接封止するCPOへの移行が不可欠であり、住友電工のInP基板・レーザー光源、NTTのIOWN構想、そしてイビデンが独占的シェアを持つAIサーバー向け高多層パッケージ基板が、2027年から2030年にかけた第2幕の主役となる。
AIデータセンターを巡る巨額投資の本質は、デジタル空間の演算競争が「1GWあたり400億ドルの資本力」「原発数基分のベースロード電源と送電網」「1ラック120kWを冷やす液冷流体技術」「1万心を超える超高密度光配線」という4つの物理的制約にぶつかったことにある。投資家と技術者が注視すべきは、華やかなAIモデルの発表ではなく、この物理的ボトルネックを解消する重電・光通信・熱管理部材の受注残高と生産能力の増強倍率にほかならない。
投資家向けの個別銘柄レポートと技術デューデリジェンスのご相談は、編集部のお問い合わせ窓口までお寄せください。







💬 この記事へのコメント 0
まだコメントはありません
最初のコメントを投稿してみましょう!⚠️ エラーが発生しました