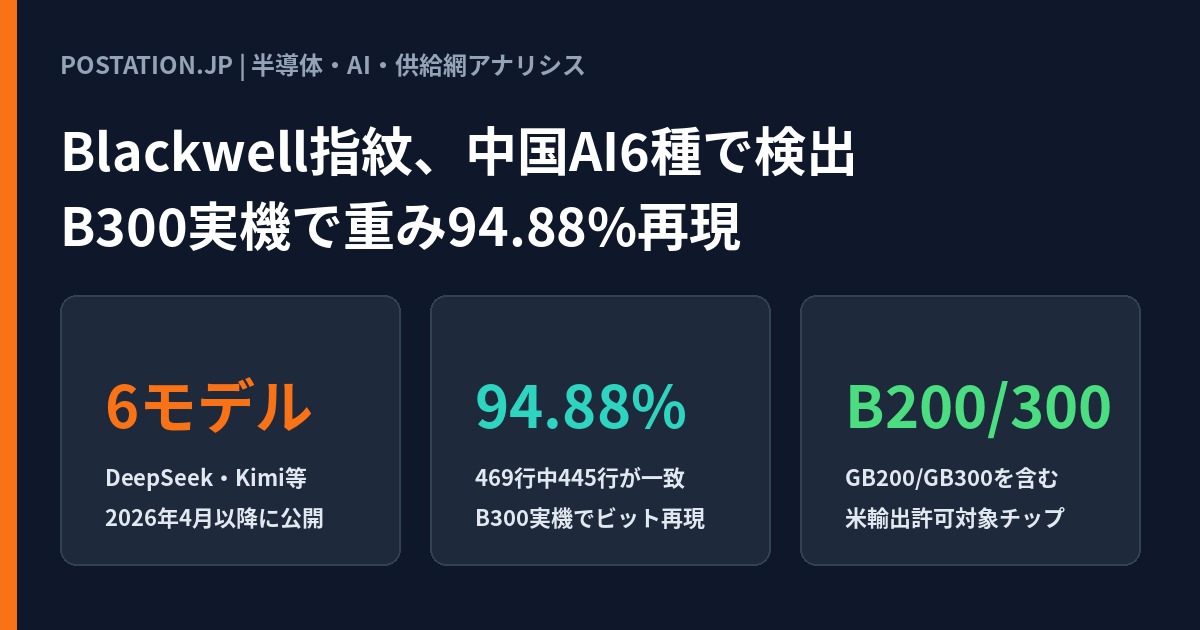
米エヌビディアの最新半導体Blackwellの痕跡が、DeepSeekやKimiなど中国4社の6モデルで検出された。研究員のデピュー氏が469行の重みをB300実機で検証し、445行の一致を突き止めた。
DeepSeekなど中国4社の6モデルでBlackwellの固有痕跡を検出
米国のAI研究員であるウィル・デピュー(Will DePue)氏は2026年11月12日付(現地報道は11月13日)で公表した技術鑑識報告書「中国の先端AIモデルにおけるNVIDIA Blackwell GPUの指紋」で、中国の主要AI開発4社が一般公開した6つの基盤モデルから、米エヌビディア(NVIDIA)の最新世代GPU「Blackwell(ブラックウェル)」に固有の数値パターンを検出したと発表した。対象となった開発企業は、DeepSeek(深度求索)、Moonshot AI(月之暗面、モデル名Kimi)、MiniMax(稀宇科技)、およびアリババグループ傘下のフィンテック大手である螞蟻集団(アント・グループ)の4社である。
米商務省産業安全保障局(BIS)の輸出管理規則(EAR)のもとで、Blackwell世代のデータセンター向け半導体である「B200」「B300」およびCPU統合型の「GB200」「GB300」は、中国(香港・マカオを含む)への輸出や再輸出に米国政府の事前許可が義務づけられている。デピュー氏の報告書によると、2026年11月時点でこれらの先端チップに対する対中輸出許可が発給された公式記録は存在しない。それにもかかわらず、2026年4月から11月にかけて中国4社が公開した主力6モデルのすべてで、前世代の「Hopper(ホッパー)」からBlackwellへの一斉移行が確認された。
これまで米国政府高官や欧米の主要メディアが、DeepSeekやMoonshot AIによるBlackwell使用を報じた事例はあったが、いずれも関係者への取材にとどまり、検証可能な技術的証拠は示されていなかった。デピュー氏の調査は、内部告発や機密資料の漏洩に一切頼らず、各社がオープンウェイト(公開重み)としてインターネット上に一般公開したAIモデルのパラメータファイルのみを解析した点に特徴がある。
具体的には、デピュー氏はDeepSeekが2026年4月に公開した「DeepSeek-V4-Flash」の重みファイルから初期状態の痕跡を残す469行のパラメータを抽出し、物理的な「Blackwell B300」チップ1基を用いて再現実験を行った。その結果、469行のうち445行を1ビットの狂いもなく完全に再現した。ここで再現率を検算すると、445行÷469行=94.8827...%となり、約94.88%の行がB300実機の出力とビット単位で一致する。残る24行(構成比5.12%)の不一致は事後的な学習更新による変動分であり、初期化段階のハードウェア環境がBlackwell B200またはB300であったことを決定づけている。また、Moonshot AIが2026年7月に公開した「Kimi K3」についても、同様にBlackwellの物理チップ実機を用いた照合で一致が確認された。
中国4社が2024年12月から2026年11月までに公開した全11モデルの世代交代を整理すると、2026年4月〜10月を境にハードウェア環境が明確に切り替わっていることが分かる(完全な検証モデル一覧はデピュー氏報告書の付録2に収録されている)。
| 開発企業(研究所) | AIモデル名 | 公開時期 | 初期作成チップの指紋(特定結果) | 備考・米国輸出規制上の扱い |
|---|---|---|---|---|
| DeepSeek(深度求索) | DeepSeek-V3 | 2024年12月 | NVIDIA Hopper | 開発元がH800使用を公開済み |
| DeepSeek(深度求索) | DeepSeek-V4-Flash | 2026年4月 | NVIDIA Blackwell B200/B300 | 対中輸出に米国許可が必要・B300実機検証済み |
| DeepSeek(深度求索) | DeepSeek-V4-Pro | 2026年4月 | NVIDIA Blackwell GB200/GB300 | 対中輸出に米国許可が必要 |
| Moonshot AI(月之暗面) | Kimi K2 | 2025年7月 | NVIDIA Hopper | 開発元がH800使用を公開済み |
| Moonshot AI(月之暗面) | Kimi K2.5 | 2026年1月 | NVIDIA Hopper | 開発元がH800使用を公開済み |
| Moonshot AI(月之暗面) | Kimi K3 | 2026年7月 | NVIDIA Blackwell GB200/GB300 | 対中輸出に米国許可が必要・実機検証済み |
| Moonshot AI(月之暗面) | Kimi K3.1-Pro | 2026年11月 | NVIDIA Blackwell GB200/GB300 | 対中輸出に米国許可が必要 |
| MiniMax(稀宇科技) | MiniMax-M2.7 | 2026年4月 | NVIDIA Hopper | 前世代アーキテクチャと一致 |
| MiniMax(稀宇科技) | MiniMax-M3 | 2026年6月 | NVIDIA Blackwell B200/B300 | 対中輸出に米国許可が必要 |
| 螞蟻集団(Ant Group) | Ling-3.0-flash | 2026年8月 | NVIDIA Hopper | 前世代アーキテクチャと一致 |
| 螞蟻集団(Ant Group) | Ling-3.1-flash | 2026年10月 | NVIDIA Blackwell GB200/GB300 | 対中輸出に米国許可が必要 |
本稿の図1が示す通り、4社はいずれも初期モデルではHopper世代を使用し、その後継モデルで一斉にBlackwell世代へ移行した。特に単体GPU構成のB200/B300だけでなく、米グレイス(Grace)CPUとBlackwell GPUを高速接続したラックスケール製品である「GB200/GB300」の指紋が、DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、Ling-3.1-flashの4モデルから検出された事実は重い。
公開重みの初期値からBlackwell B300の物理指紋を逆算する仕組み
なぜ学習を終えて公開されたAIモデルの重みファイルから、作成に使われた半導体の型番まで特定できるのか。その技術的な根拠は、GPU上で動く擬似乱数生成器(PRNG:計算式によって乱数に近い数列を作る仕組み)の並列スレッド割り当てと、浮動小数点演算のハードウェア固有の丸め処理にある。
大規模言語モデル(LLM)の開発では、学習を開始する前に数千億〜数兆個のパラメータ(重み行列)を乱数で初期化する。この初期化処理はCPUではなく、学習を実行するGPUクラスタのメモリ(HBM)上で直接、エヌビディアの数値計算ライブラリ(cuRANDやPyTorchのCUDAカーネル)を呼び出して並列実行される。このとき、GPU内部のストリーミング・マルチプロセッサ(SM:GPU内の基本演算ブロック)の数やスレッドブロックの分割単位、さらにはBFloat16(16ビット脳浮動小数点数)やFP8(8ビット浮動小数点数)への型変換時の微小な丸め規則が、ハードウェアの世代や構成ごとに異なる。
通常、長時間の事前学習を経ると初期値は勾配降下法によって書き換えられる。しかし、MoE(Mixture of Experts:複数の専門家サブネットワークを切り替えて処理する構造)を採用する最新モデルでは、学習中にほとんど更新されない疎な領域や、埋め込み層・正規化層の特定の直交成分に、初期値の数値的な痕跡(残差)がそのまま残る。デピュー氏は、この残差からモデル作成時の初期乱数シードとスレッド配置を逆算し、どのハードウェア構成であればその初期値行列を生成できるかを総当たりで照合した。
本稿の図2に整理した3段階の鑑識フローでは、同じHopper世代の内部(H800、H100 SXM、H200)はSMの基本設計と乱数カーネルの挙動が共通しているため、重みの指紋だけでは相互に区別できない。表1でDeepSeek-V3やKimi K2/K2.5に「H800」と記載されているのは、各開発企業が技術論文等でH800の使用を自ら開示した事実に基づくものであり、指紋解析単独では「Hopper世代」までの特定となる。
一方、Hopper世代からBlackwell世代への移行、さらにBlackwell内部での「B200/B300(x86 CPUホスト接続)」と「GB200/GB300(ArmベースGrace CPUとのNVLink-C2C一貫メモリ接続)」の間では、メモリアロケーションの境界条件と初期化カーネルの並列分割幅が明確に異なる。このため、重み行列の初期値パターンからB200/B300とGB200/GB300を高い精度で識別できる。
デピュー氏はこの数値パターンを生み出し得る別メーカーの半導体として、特殊な構成を組んだ米アドバンスト・マイクロ・デバイセズ(AMD)製ハードウェア(Instinct MI300X/MI325X系とみられる)が理論上の唯一の代替候補になることを突き止めた。しかし、該当するAMD製先端GPUも米国の対中輸出規制の対象であり、さらにDeepSeek-V4-Flashの469行の検証ではAMD製ハードウェアによる生成の可能性が数学的に排除された。結果として、これらの重みはBlackwell実機上で生成されたと結論づけられた。なお、デピュー氏は、重みの初期作成がBlackwellで行われたことは確実である一方、その後の本学習(トレーニング)の全工程にBlackwellが使われたかどうかについては「強く裏づけるが、初期化のみをBlackwellで行い別チップへ転送した可能性を完全には排除できない」として、確認済みの事実と推論を厳密に区別している。
エヌビディア決算の地域別売上推移と第三国迂回ルートの構造
米国が対中輸出を厳しく制限しているBlackwellが、なぜ2026年春までに中国の主要AI開発4社の開発環境へ一斉に届いたのか。その背景にある資本の移動と供給網の変化は、エヌビディアが米証券取引委員会(SEC)に提出した年次報告書(Form 10-K)および四半期報告書(Form 10-Q)の地域別売上高と受注残のデータから浮かび上がる。
米商務省は2022年10月と2023年10月の2度にわたり先端半導体の対中輸出規制を強化し、演算性能密度(TPP:Total Processing Performance)に上限を設けた。これにより、エヌビディアが中国向けに性能を落として設計した「A800」「H800」も2023年10月以降は輸出許可制(事実上の禁輸)となった。さらに2025年1月にはAI拡散枠組み(AI Diffusion Framework)が導入され、第三国を経由した先端GPUクラスタの不正移転やリモートアクセスに対する監視網が引き締められた。
しかし、エヌビディアのSEC開示書類における請求先(Billing location)ベースの地域別売上高を時系列で検証すると、中国(香港を含む)の売上比率が低下する一方で、シンガポールや台湾、および東南アジア地域のクラウド・データセンター事業者向けの売上が急膨張している実態が分かる。ここで2つ目の検算を行う。エヌビディアの2025会計年度(2024年2月〜2025年1月期、Form 10-K開示)の総売上高1,304億9,700万ドルのうち、香港を含む中国向け売上高は171億800万ドルであり、総売上高に対する比率は171.08億ドル÷1,304.97億ドル=13.11%であった。これに対し、請求先としてのシンガポール向け売上高は236億8,400万ドルに達し、比率は236.84億ドル÷1,304.97億ドル=18.15%と中国を上回った。両地域を合算すると407億9,200万ドル(総売上高の31.26%)にのぼる。
エヌビディアはForm 10-Kの注記で、シンガポールへの請求分の大半は米国や他地域の顧客がシンガポール法人を通じて集中購買し、実際の物理的な出荷先は別地域であるとしている。その通り実際の出荷先(Ship-to location)ベースではシンガポール国内への配送は総売上高の2%未満にとどまるが、マレーシア(ジョホール州)やインドネシアなどの東南アジア圏、および中東地域のデータセンターには、2025年後半から2026年前半にかけて大量のB200およびGB200 NVL72ラックが納入された。
中国企業がBlackwellの演算能力を手にする経路は大きく2つ存在する。第1の経路は、シンガポールやマレーシア等の第三国に設立された関連法人や現地のGPUクラウド事業者(ネオクラウド)のデータセンターに設置されたBlackwellクラスタへ、光海底ケーブル経由でリモート接続してモデルの初期化と学習を実行する「国外リモート学習」である。第2の経路は、サーバー筐体に組み込まれた後に複数の中継商社を経由して中国本土へ物理的に持ち込まれる迂回調達である。
重みのデジタル鑑識が突き止めたのは「モデルの重みがBlackwellの物理チップ上で初期化された」という事実であり、そのチップが中国本土のデータセンター内に置かれていたか、あるいは東南アジア等の国外データセンターに置かれていたかまでは重みファイルからは判別できない。しかし、2025年初頭まで輸出規制の抜け穴となっていた海外クラウドの遠隔利用に対しても米政府が規制網を広げるなかで、2026年4月以降の最新6モデルすべてにBlackwellの痕跡が刻まれていた事実は、ハードウェアの物理的移動または計算資源へのアクセス制限に依然として抜け穴が存在することを示している。
CoWoS-Lパッケージの物理構造と日本企業の部材・検査装置の急所
中国の開発各社がリスクを冒してまでHopper(H800等)からBlackwell(B200/B300・GB200/GB300)への移行を急いだ理由は、単なる演算速度の向上だけでなく、パッケージ構造の刷新によるメモリ帯域と省電力性能の飛躍にある。
本稿の3Dモデルおよび図2の下段に示した通り、Blackwellは台湾積体電路製造(TSMC)の4NPプロセスで製造された2つの巨大な演算ダイ(露光装置の面積限界であるレチクルリミットサイズ)を、10テラバイト/秒(TB/s)の双方向帯域を持つ「NV-HBI(High-Bandwidth Interface)」で単一の論理GPUとして結合している。この2つの演算ダイの周囲に8個の広帯域メモリ「HBM3e」(B200では計192GB、B300では高容量化されたHBM3eにより計288GB)を配置し、TSMCの次世代2.5次元パッケージ技術である「CoWoS-L」で統合している。
前世代のHopper(H100/H800)が採用していた「CoWoS-S」は、1枚の巨大なシリコンインターポーザ(中継基板)の上にGPUダイとHBMを載せる構造であった。しかし、Blackwellのように演算ダイを2枚並べると面積がレチクル限界の3.3倍以上に達し、1枚のシリコンインターポーザでは割れや反りが発生して歩留まりが低下する。そこでCoWoS-Lでは、微細な配線が必要なダイ接続部分だけに小型のシリコンブリッジ(LSI:Local Silicon Interconnect)を埋め込み、全体を有機インターポーザ(RDL:再配線層)で固める複合構造を採用した。さらに、ラックスケール製品のGB200およびGB300では、1ラックあたり36個のGrace CPUと72個のBlackwell GPUを水冷マニホールドと銅ケーブル(NVLink Spine)で高密度に接続し、第2世代Transformer Engineによって4ビット浮動小数点(FP4)演算をハードウェアレベルで高速化している。
このBlackwellの複雑な積層構造を製造するうえで、代替不可能な供給網の急所を握っているのが日本の半導体部材・製造装置メーカーである。
- 高多層パッケージ基板と層間絶縁材(イビデン・新光電気工業・味の素・レゾナック): CoWoS-Lのインターポーザを載せる土台となる大型FC-BGA(フリップチップ・ボールグリッドアレイ)基板は、面積の拡大と層数の増加によって極めて高い平坦度(反り制御)が求められる。この先端AIサーバー向けFC-BGA基板ではイビデンと新光電気工業が世界シェアの双璧をなし、その微細配線の層間を絶縁するフィルム材「ABF(味の素ビルドアップフィルム)」は味の素が世界シェアのほぼ100%を握る。また、再配線層向けの感光性絶縁材やダイボンディングフィルムではレゾナック・ホールディングスが主力サプライヤーとなっている。
- HBM3eの薄化・切断と長時間テスト(ディスコ・アドバンテスト): Blackwell1基あたり8個搭載されるHBM3e(韓国SKハイニックス等が供給)は、DRAMウエハーを極限まで薄く削って積層する。この研削(グラインダ)と切断(ダイサ)の工程ではディスコの精密加工装置が不可欠である。さらに、2つの演算ダイと8個のHBM3eを統合したBlackwellパッケージは、1個あたりの製造原価が極めて高いため、不良品を排除するための検査時間がHopper世代の2〜3倍に延びている。このSoCテスタ市場ではアドバンテストの「V93000」シリーズがエヌビディアの認定検査装置として独占的な地位を占めており、B200からB300への世代交代に伴ってテスタ需要が一段と拡大している。
中国のAI企業が自国製のAI半導体(ファーウェイのAscend 910B/910C等)への切り替えを進めようとしても、日本の部材メーカーと装置メーカーが支えるCoWoS-Lのパッケージ密度とHBM3eのメモリ帯域(1基あたり8TB/秒)の壁は厚い。だからこそ、DeepSeekやMoonshot AIは数千億パラメータの新型モデル(V4やK3)の初期構築にあたり、依然としてエヌビディアのBlackwellアーキテクチャに依存せざるを得なかった。
米国の輸出管理強化と半導体サプライチェーンへの波及
公開モデルの重みから半導体の固有指紋を抽出・再現するデピュー氏の手法が確立されたことで、今後の米中半導体摩擦とサプライチェーン管理は新たな段階に入る。これまで米商務省産業安全保障局(BIS)の執行部門は、税関データや商社の帳簿、内部告発を手がかりに迂回輸出を追跡してきた。しかし今後は、中国企業がオープンウェイトとして公開したAIモデルのパラメータファイルを解析するだけで、どの世代のどの構成のGPU(B200/B300か、ラックスケールのGB200/GB300か)がいつ使用されたかを外側から直接立証できるようになる。
この結果、今後は2つの構造変化が進むとみられる。第1に、中国のAI開発企業はハードウェアの調達経路が特定されるのを防ぐため、これまで強みとしてきた「オープンウェイトでのモデル公開」を控え、API経由のみでサービスを提供するクローズドモデルへ回帰する誘因が働く。また、初期化処理だけを既存のHopperやCPU上で実行して擬似乱数の痕跡を消去したうえで、Blackwellクラスタへ転送して本学習を行う「指紋ロンダリング」のような対抗措置が導入される可能性もある。
第2に、米国政府による第三国(シンガポール、マレーシア、中東諸国など)のデータセンターに対する物理監査と、GPUクラウド事業者への「顧客確認(KYC:Know Your Customer)」義務が一段と厳格化される。とくにラックスケール製品であるGB200/GB300の指紋が4つの中国モデルから検出されたことは、単体GPUの密輸だけでなく、大規模な水冷データセンター設備を持つ海外拠点の計算資源が中国企業の開発に供与されている実態を浮き彫りにした。
エヌビディアのBlackwell世代をめぐる攻防は、最先端のパッケージ技術(CoWoS-L)と日本の部材・検査装置が作り出した圧倒的な演算性能に世界のAI開発が集約される一方、公開された数行のパラメータからでもその使用履歴が暴かれるという、技術と規制の緻密なせめぎ合いを映し出している。
投資家向けの個別銘柄レポートと技術デューデリジェンスのご相談は、編集部のお問い合わせ窓口までお寄せください。











💬 この記事へのコメント 0
まだコメントはありません
最初のコメントを投稿してみましょう!⚠️ エラーが発生しました