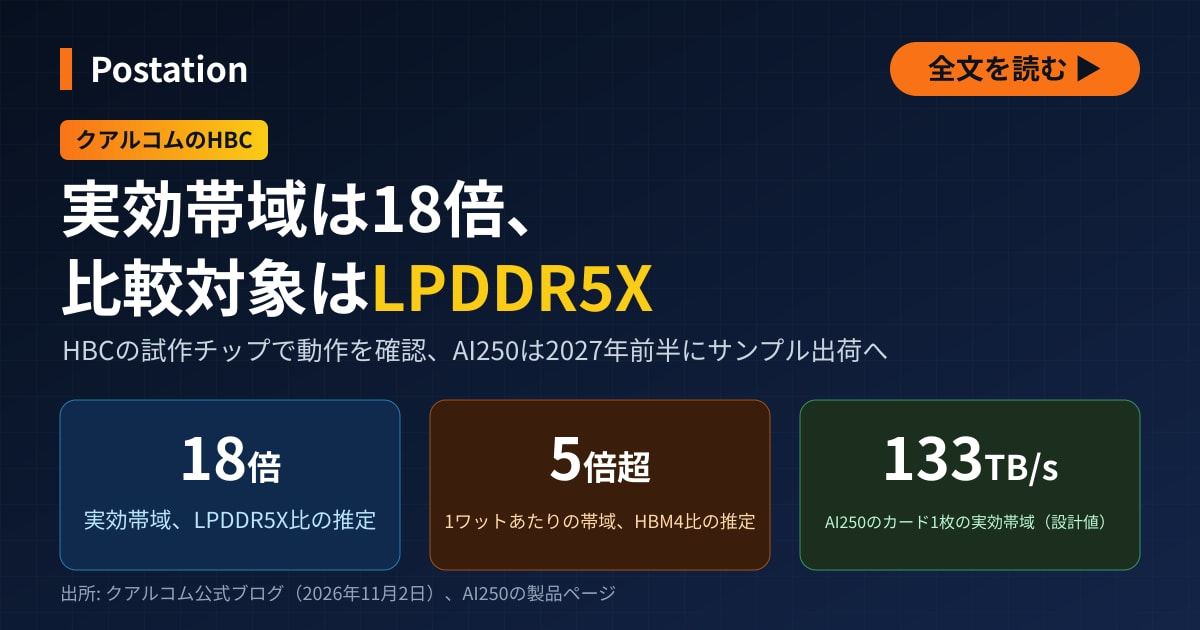
米クアルコムは11月2日、計算回路をメモリーのそばに置く技術「HBC」の第1世代のチップを試験し、実効帯域がLPDDR5X比で18倍になるとの推定を示した。HBM4の5倍超は消費電力1ワットあたりの帯域の比で、速さの比ではない。
クアルコムの公式ブログによると、同社は米カリフォルニア州サンディエゴの研究所で、第1世代のHBC(ハイ・バンドウィズ・コンピュート)の試作チップを動かした。半導体の検査で一般的な自動試験装置を用い、製品に相当する規模を想定して、乱数で作ったAIモデルの重み(パラメーター)と途中の計算結果を流した。メモリーの読み書きの経路全体とメモリーのそばでの計算が、設計どおりに動くことを確かめたという。
同社が示した数字は2つある。1つは実効帯域で、計算に実際に使えるメモリーの帯域(1秒あたりに読み書きできるデータの量)を指す。スマートフォンなどに使う省電力メモリー「LPDDR5X」の18倍と見積もった。もう1つは消費電力1ワットあたりの帯域で、広帯域メモリー(HBM)の最新規格「HBM4」の5倍を超えるとした。どちらも、試作チップの実測値を製品で想定する動作条件に換算し、他社製品の公表仕様と比べた同社の推定値だ。製品の性能は実装や処理の内容で変わると、同社は断っている。
HBCは積み重ねたDRAMの下のロジックチップで計算し、外へは結果だけを送る
HBMとHBCは、どちらもDRAMの層を土台のチップ(ベースダイ)の上に積み重ねる。違いは、土台のチップで計算するかどうかだ。
いまのAI向け半導体では、HBMを演算チップの横に並べ、先端パッケージ技術でつなぐのが主流だ。このパッケージは高価で供給も限られると、同社は指摘する。計算に使うデータは、すべてHBMから演算チップへ送らなければならない。同社によると、HBMはメモリーの中で読み出せる量と外へ送れる量がほぼ同じだ。最新のHBMは接続を2,048ビット幅に広げ、1個で毎秒2テラバイト近くを送れると同社は説明する。土台のチップを先端のロジック半導体の製造技術で作り、顧客ごとに作り分ける「カスタムHBM」も出てきたが、データを演算チップへ送り出す点は変わらないと同社はみる。HBMの積層と接合の方式の違いは、Hot Chips 2026のメモリー講演を扱った記事で取り上げた。
HBCは、計算の一部をメモリーの中へ移す。土台のロジックチップにDRAMの層を貼り合わせ、メモリーからの読み出しが多い演算をこのチップでこなす。外へ送るのは計算結果だけなので、メモリーの中で読み出したデータを、外へ送れる量の何倍も計算に使える。同社は、この計算に使える帯域を実効帯域と呼ぶ。
AIが文章を生成する段階では、トークン(単語の断片)を1つ出すたびに、モデルの重みと文脈をメモリーから読み出す必要がある。同社によると、この段階は計算の負荷が軽く、処理にかかる時間はメモリーから演算チップへデータを送る速度で決まる。同社はこの制約を「メモリーの壁」と呼び、HBCで和らげるとしている。
HBCは演算チップを置き換えるものではない。同社のDragonflyのAIアクセラレーターのような演算チップはそのまま使い、処理の振り分けなど込み入った処理を任せる。HBCが受け持つのは、メモリーからの読み出しが多い演算だ。
AI250の実効帯域はAI200の18倍、ラックの仕様からも同じ値
11月の発表は18倍を、LPDDR5Xの公表仕様との比として示した。7月10日の公式ブログは、同じ18倍を製品の比として示していた。第1世代のHBCを搭載する「Dragonfly AI250」は、LPDDR5Xを使う「Dragonfly AI200」と比べ、実効帯域を18倍に高める設計だ。同社は次の世代のHBCを積む「Dragonfly AI300」で、実効帯域をAI200の54倍に高めると見込む。AI200とAI250の製品ページに載る設計値は次のとおりだ。
| 仕様 | AI200 | AI250 |
|---|---|---|
| メモリー | LPDDR5X | HBC第1世代 |
| カード1枚の容量 | 768ギガバイト | 768ギガバイト |
| カード1枚の帯域(AI250は実効帯域) | 毎秒約7.4テラバイト(編集部の計算) | 毎秒133テラバイト |
| ラック1台のカード枚数 | 56枚 | 56枚 |
| ラック1台の容量 | 43テラバイト | 43テラバイト |
| ラック1台の帯域(AI250は実効帯域) | 毎秒0.414ペタバイト | 毎秒7.455ペタバイト |
| ラック1台の熱設計電力 | 140キロワット | 140キロワット |
AI200のカード1枚の帯域は、ラックの値を56で割って編集部が算出した。AI250のラックの実効帯域をAI200のラックの帯域で割ると18.0倍となり、ブログの18倍と一致する。AI250のラックの実効帯域は、カード1枚の値の56枚分の毎秒7,448テラバイトとほぼ同じだ。
表の項目のうち、カードの枚数とメモリーの容量、ラックの熱設計電力は両機種で同じで、違うのはメモリーの種類と帯域だ。AI200の帯域は製品ページで実効とは書かれておらず、AI250は実効帯域として載っている。熱設計電力あたりでみても、AI250はAI200の18倍になる(編集部の計算)。同社は2025年10月27日に両機種を発表した時点では、AI250の実効帯域を「10倍超」、消費電力を「はるかに低い」とし、ラック1台の消費電力を160キロワットとしていた。
HBM4と比べた消費電力1ワットあたりの帯域は5倍超、他社の公表仕様からの推定
同社はHBM4との比較に、実効帯域を消費電力で割った「消費電力1ワットあたりの帯域」を使った。発表の時期と比べ方によって、示した数字は異なる。
同社は11月の発表で、試作チップの実測値から換算してHBM4の5倍超とした。7月31日のブログは、カード1枚の単位で他社製品の公表仕様と比べ、多くの要求をまとめて処理する場合にHBMの6倍と推定していた。このブログは比べたHBMの世代を示していない。AI250の製品ページは、GPUを使う現行の方式と比べ、カード1枚の消費電力1ワットあたりの帯域を4〜8倍としている。
比べたHBM4の製品名や処理の内容を、同社は11月の発表で明らかにしていない。この指標は帯域を電力で割った値で、AIが回答を返す速さやシステム全体の消費電力を比べたものではない。
接合技術は受託生産会社などと開発、製品の1つは製造工程に回した
製造では、半導体の受託生産会社や組み立て・検査を請け負う会社と協力し、ウエハー同士を貼り合わせる技術を複数の世代の製造技術にわたって開発・評価してきたという。メモリーの欠陥は試験で見つけ、予備の回路に切り替えて補う設計にした。同社はこれまでに、DRAMをロジックチップに直接貼り合わせる技術を実用化し、半導体の標準化団体JEDECでLPDDRの規格づくりにも携わってきたと説明する。
提携先の社名は明らかにしていない。HBCに積むDRAMの種類や積層数も公表していない。同社の発表とブログでLPDDR5Xに触れているのは、性能の比較対象としてだけだ。
同社によると、データセンター向け製品の1つは設計を終え、製造工程に回した(テープアウト)。どの製品かは明らかにしていない。ロジックチップにDRAMの層を貼り合わせたチップは生産立ち上げの初期段階にあり、良品が得られているという。AI250は2027年前半にサンプル出荷を始め、同社のラック製品に組み込む予定だ。2025年10月の発表では、AI250の商用化を2027年と見込んでいた。
データセンター50億ドルの内訳は非公表、AI250のサンプル出荷は年度末の3〜9か月前
クリスティアーノ・アモン最高経営責任者(CEO)は11月4日の決算発表で、データセンター事業の売上高を2027年度(2027年9月期)に50億ドルとする目標を改めて示した。製品別の内訳は開示していない。AI250のサンプル出荷から年度末の2027年9月までは、3〜9か月しかない。サンプル出荷は、売上高を計上する時期を示すものではない。アモンCEOは、2027年度にスマートフォン以外の売上高が前年度比で60%超伸びるとの見通しも示した。
同社は10〜12月期の売上高を104億〜112億ドルと見込んだ。この見通しの中で、データセンター向けの額は示していない。2026年7〜9月期の事業別の売上高は次のとおりで、全社の行は訴訟の和解に伴う顧客への支払いを除いた調整後の値だ。米国会計基準の全社の売上高は103.22億ドルだった。
| 区分 | 7〜9月期の売上高 | 前年同期比 |
|---|---|---|
| 全社(調整後) | 104.42億ドル | 7%減 |
| 半導体事業 | 90.15億ドル | 8%減 |
| うちスマートフォン向け | 51.37億ドル | 26%減 |
| うち自動車向け | 19.90億ドル | 89%増 |
| うちIoT向け | 18.88億ドル | 4%増 |
| ライセンス事業 | 13.04億ドル | 7%減 |
事業別の合計が調整後の全社の売上高と合わないのは、主に訴訟の和解に伴う顧客への支払いを調整後の数字から除いたためだ。自動車向けは四半期として過去最高だった。自動車向けとIoT向けの売上高は合わせて38.78億ドルと、前年同期より36%増えた。半導体事業の売上高のうち、スマートフォン向けは57.0%だった。
半導体業界では、ウエハーの製造や組み立て、先端パッケージ、メモリーなどの調達コストが上がっている。同社は上昇分を製品価格に転嫁しており、半導体事業の粗利益率に効果が十分に表れるのは2027年度下期になるとしている。
アマゾンに最大2,500万株のワラント、権利確定の条件の購入額は600億ドルが上限
アマゾンとの協業は、クアルコムが9月8日に発表していた。大規模なAIデータセンター向けに、アマゾン向けのカスタム半導体を複数世代にわたって手がけ、AIの推論で協力する。通信速度が最大毎秒1.6テラビットの光通信製品も共同で開発する。11月4日の決算発表は見出しでこの協業に触れたが、本文に具体的な内容はない。9月8日の発表と決算発表のいずれにも、HBCやAI250への言及はない。
取引条件の一部は、11月4日に提出した年次報告書の注記に記載がある。クアルコムは2026年9月、アマゾン・データ・サービシズの関連会社に対し、自社株を最大2,500万株取得できるワラント(新株予約権)を発行した。発行時点の公正価値は総額18億ドルだった。権利は、特定の取引契約の締結や確定注文、購入額が一定の水準に達した場合などに応じて段階的に確定する。権利確定の条件となる購入額の上限は600億ドルで、行使期間と確定期間はいずれも10年だ。
2,500万株のうち約400万株分は、当初の購入確約に基づき、発行と同時に権利が確定した。ワラントの価値は、関連する売上の計上に合わせて売上高から差し引く。すべての権利が確定した場合、差し引く額は購入額の上限の3.0%にあたる(編集部の計算)。年次報告書は、データセンター向けの製品としてCPU、AIアクセラレーター、通信用製品を挙げ、「Dragonfly」ブランドで開発中の製品も含むとしている。アマゾンがどの製品を購入するかは記載がない。
年次報告書はHBCを、メモリーの近くで計算してAI推論の効率を高める技術と位置づけている。18倍はLPDDR5Xと比べた実効帯域の推定で、HBM4に対する優位は消費電力1ワットあたりの帯域でしか示されていない。カード1枚で毎秒133テラバイトという設計値が実際のAIモデルで出るのか、比べたHBM4がどの製品なのかは、2027年前半に始まる予定のAI250のサンプル出荷で初めて確かめられるようになる。アマゾンが購入額に応じて権利を得るワラントの対象にAI250が入るかどうかも、まだ開示されていない。
(2026年11月14日訂正)初版で、HBCが「HBM4比で最大18倍の高速化」を実現するとあったのは誤りでした。クアルコムが示した18倍はLPDDR5Xと比べた実効帯域の推定値で、7月にはLPDDR5Xを使うAI200との比として公表されていました。「HBM4比で5倍超の電力効率」とあったのは、消費電力1ワットあたりの帯域がHBM4の5倍超という意味です。これは実測値を想定した動作条件に換算し、他社製品の公表仕様と比べた同社の推定値です。
初版はHBCの構造を、GPUなどの演算チップの真上にTSV(シリコン貫通電極)でLPDDRを積む「XPU→TSV→LPDDR」と説明していました。TSVを数万〜数十万本並べるとの記述や、接合の方式を銅同士のハイブリッド接合と特定した記述も含め、いずれも同社の資料にはありませんでした。資料が示しているのは、DRAMの層を土台のロジックチップに貼り合わせ、演算チップと仕事を分担する構成です。積層するDRAMの種類は記載されていません。演算チップの熱がLPDDRに伝わるといった、この構造を前提にした説明も削除しました。
アマゾンがHBCを採用した推論用アクセラレーターの導入を決めたとの記述は、クアルコムの発表にも年次報告書にも根拠がないため削除しました。アマゾンとの協業を決算と同時に発表されたとしたのも誤りで、発表は9月8日でした。価格転嫁の効果が出る時期を、初版はデータセンター向けの出荷が軌道に乗る時期と結びつけましたが、同社の説明にその関係はありません。
初版は、調整後の売上高と事業別の売上高の合計との差を戦略投資部門などによるものとしましたが、主な要因は訴訟の和解に伴う顧客への支払いを調整後の売上高から除いたことでした。自動車向けとIoT向けの前年同期の合計を約28.68億ドル、増加率を35.2%としたのは、それぞれ28.60億ドル、35.6%の誤りでした。ライセンス事業の「営業利益率約70%」とあったのは、売上高に対する税引き前利益の比率の誤りで、この記述は削除しました。データセンター事業の目標を全社売上高への上乗せとして計算した11.6%の記述は、前提が成り立たないため削除しました。
このほか、出所を確かめられなかったHBM4の帯域「21〜24TB/s」、消費電力の4〜6割がデータの移動に使われるとの記述、日本の装置・素材メーカーが世界シェアの過半から8割超を握ってHBCの製造を支えるとの説明と個別の社名、エヌビディアのシェア8割超も削除しました。見出しの「HBC半導体」は社名と誤解されるおそれがあるため改めました。3Dモデルは資料にない構造を描いていたため削除しました。
投資家向けの個別銘柄レポートと技術デューデリジェンスのご相談は、編集部のお問い合わせ窓口までお寄せください。








💬 この記事へのコメント 0
まだコメントはありません
最初のコメントを投稿してみましょう!⚠️ エラーが発生しました